AI 從 OCR 開始:打造文件 AI 不可或缺的基礎
企業文件管理正迅速演進。
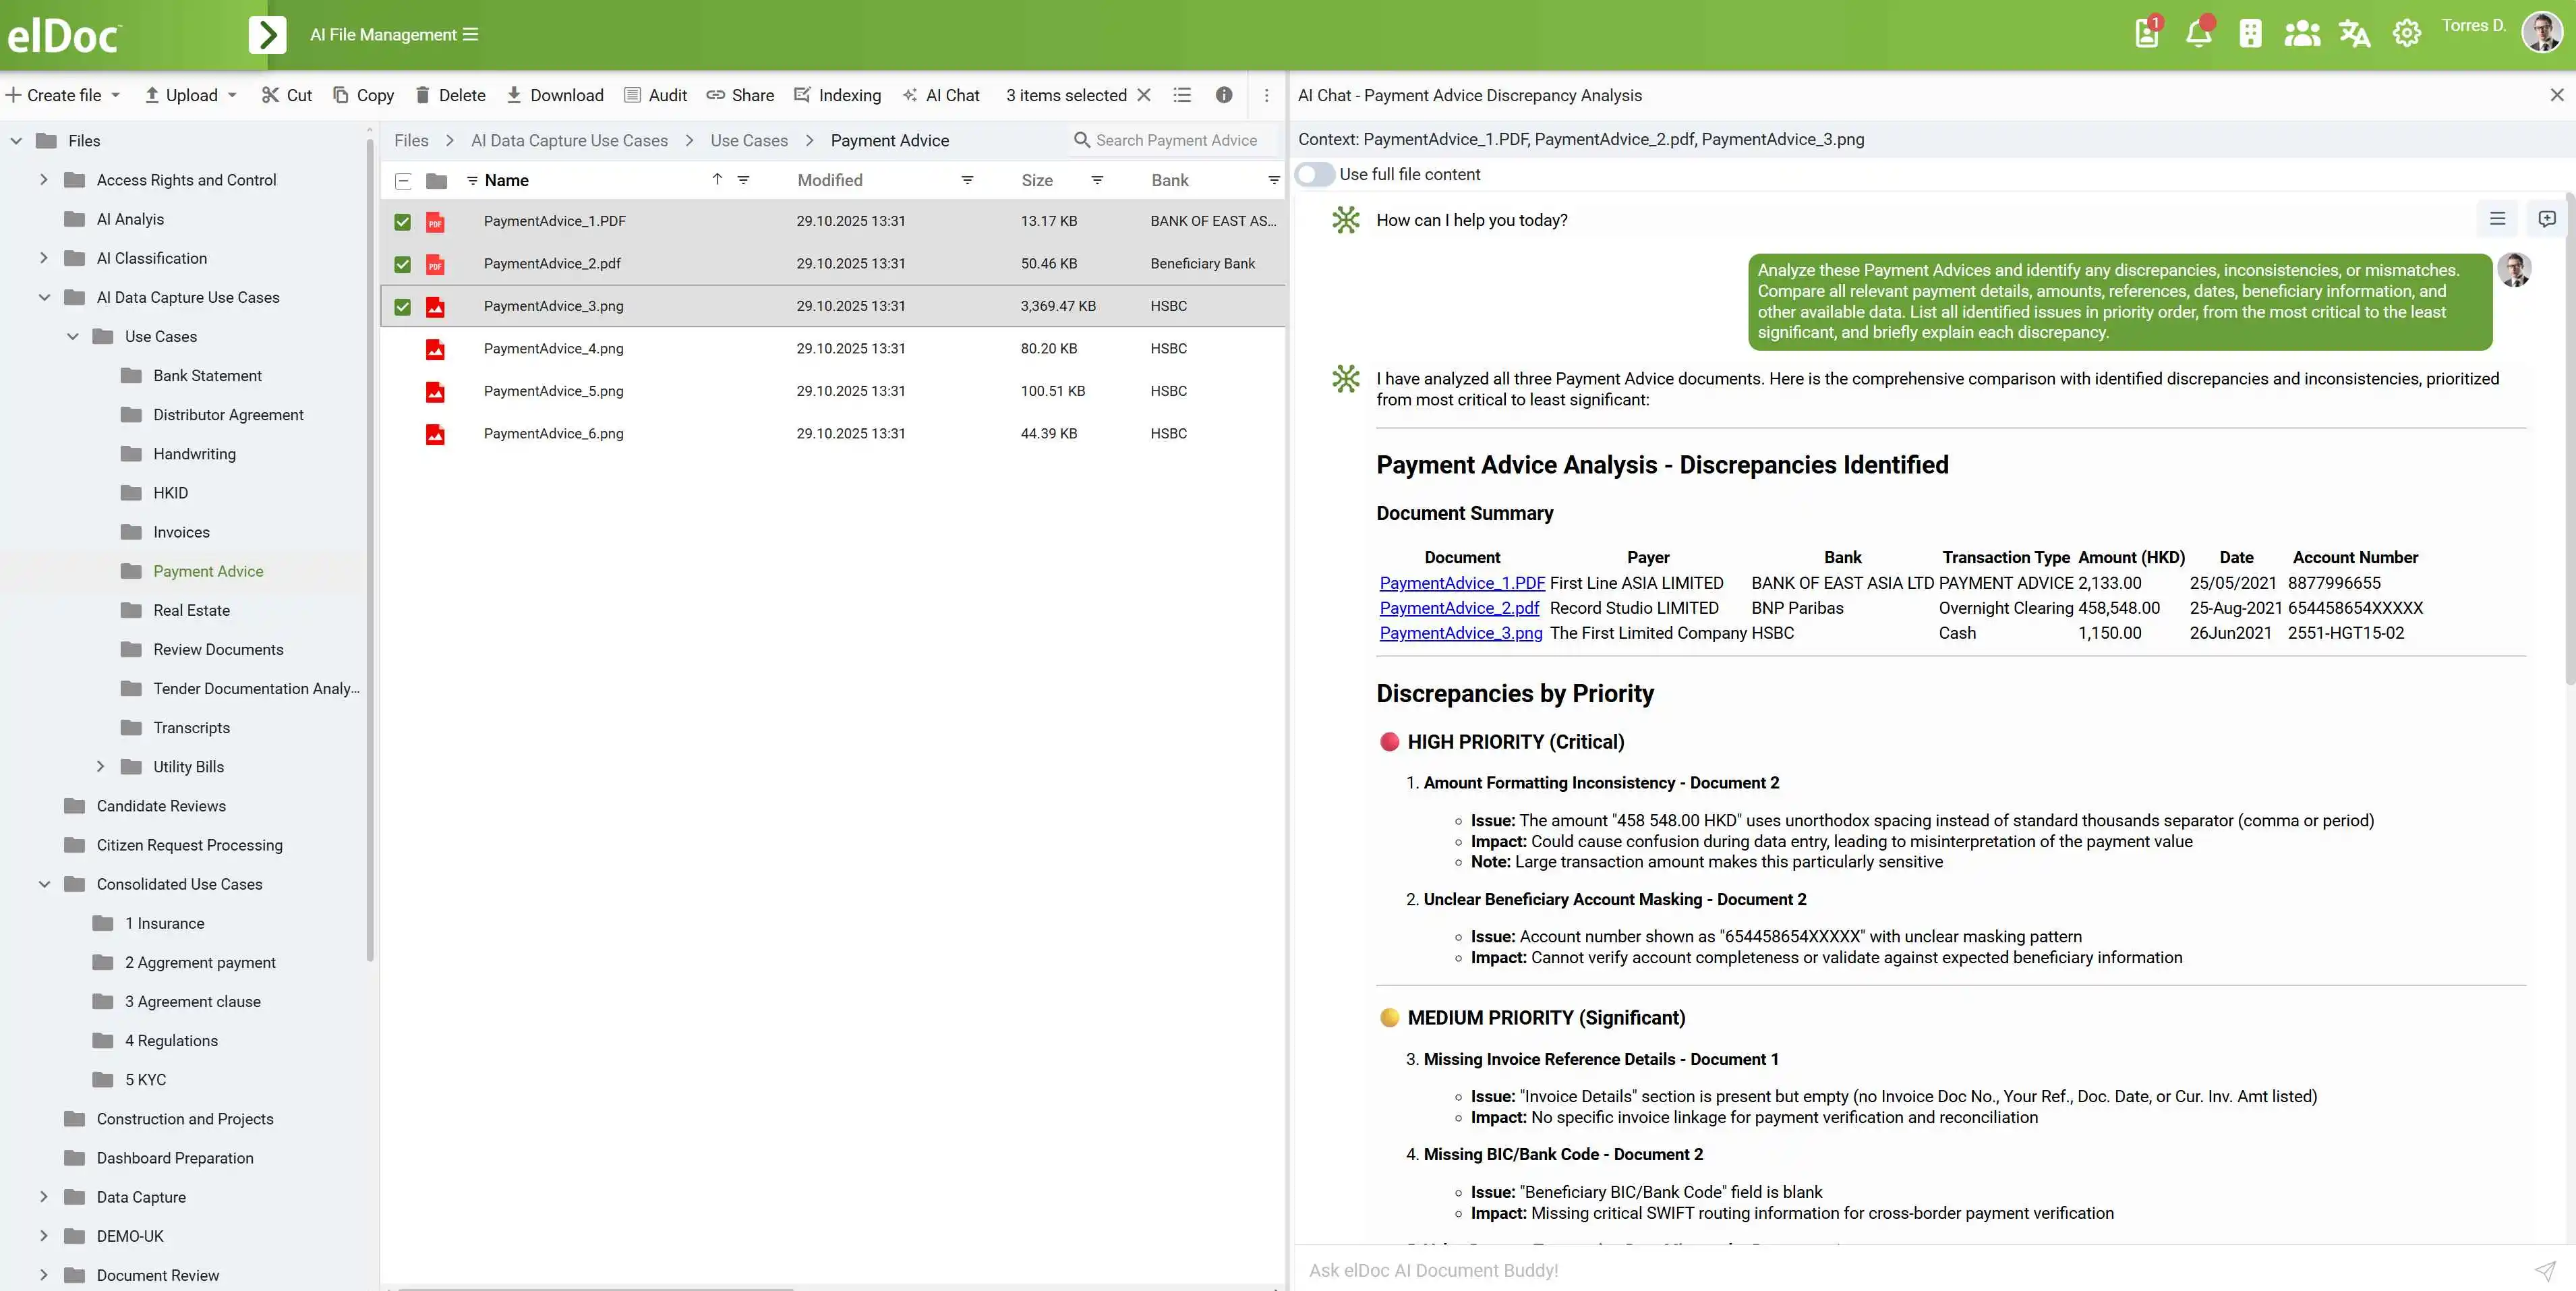
企業正將 RAG、AI 搜尋、AI 文件代理、智能資料擷取及生成式 AI 引入儲存數百萬份文件的資料庫。
目標十分明確:企業不再滿足於單純儲存文件,而是希望運用 AI 提問、擷取資訊、識別風險、比對紀錄及自動化工作流程。
然而,一個根本問題卻很容易被忽略。
AI 無法可靠地處理自己讀取不到的資訊。
企業仍有大量資訊以掃描 PDF、圖片、拍攝的文件、歷史紀錄、申請表、證書、對帳單及其他影像格式呈現。
PDF 在人眼看來可能清晰可讀,但檔案底層卻可能幾乎沒有機器可讀的文字,甚至完全沒有。
你可以在其上建構先進的 RAG 架構、串接 LLM,並引入 AI 代理。
但在此之前,必須先有人或某種技術讀取文件內容。
這正是 OCR 成為文件 AI 基礎的原因。
AI 的效能取決於底層文件的可讀性
假設一家企業的文件庫儲存了過去十年的業務紀錄。
其中包括合約、發票、客戶申請表、付款通知、往來函件、證書、對帳單及掃描的歷史紀錄。
現在,這家企業導入了 AI 助理。
使用者提出以下問題:
「找出所有金額與佐證文件不符的付款通知,並指出最重要的差異。」
這看似是 AI 要解決的問題。
而最終確實如此。
但在 LLM 分析文件、RAG 擷取相關內容,以及 AI 文件代理比對資訊之前,底層文件必須先轉換為機器可讀的格式。
對於文字層完整的數碼文件,這項條件可能早已具備。
但掃描文件和圖片通常並不具備這項條件。
OCR 正是彌補這項落差的關鍵。
將 OCR 視為獨立步驟的問題
在許多文件處理環境中,OCR 仍是獨立的處理流程。
文件進入系統。
使用者上傳文件。
另一項服務負責執行 OCR。
接著,處理後的檔案或文字還需傳輸、建立索引或進行同步。
完成這些步驟後,才能開始資料擷取、搜尋、RAG 或其他 AI 處理。
當 OCR 的主要用途是建立可搜尋的 PDF 時,這種架構是合理的。
但當企業希望 AI 持續處理文件時,這種架構便不再理想。
文件既已進入系統,為甚麼還要經過另一個獨立的處理環節,AI 才能使用其中的資訊?
elDoc 採用不同的方式。
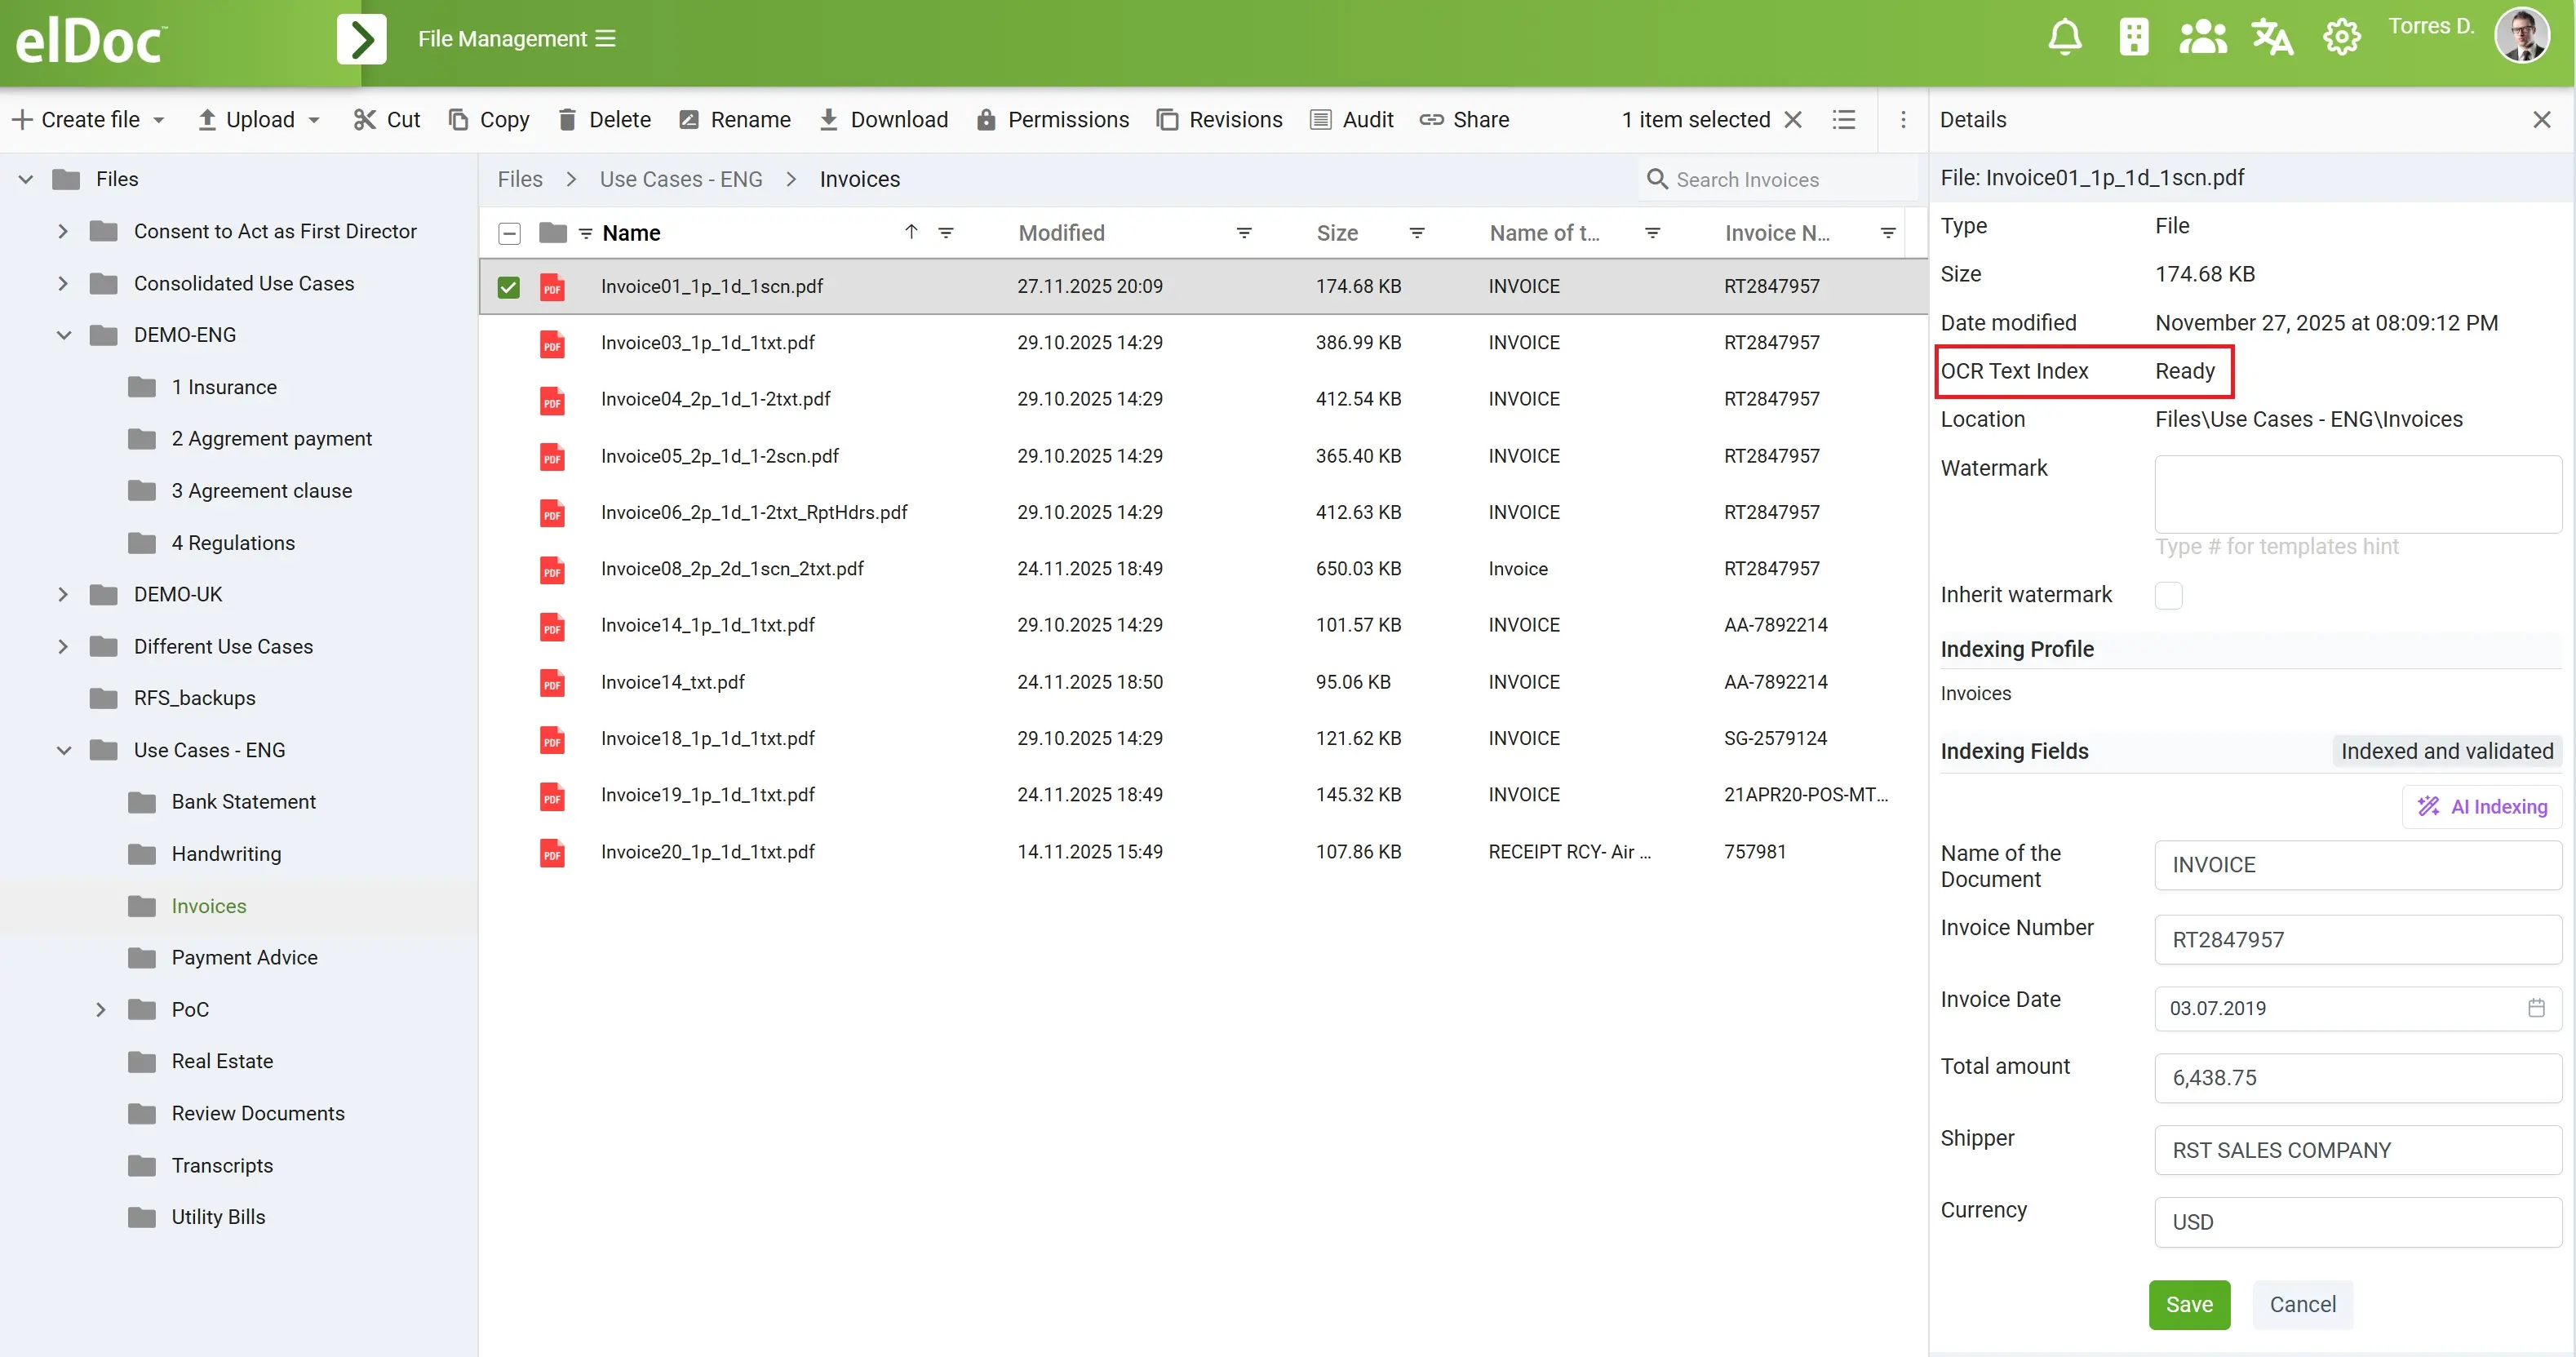
文件進入 elDoc 時,即可執行 OCR
使用者無須另行啟動 OCR 流程。
文件可透過 PDF、掃描檔、圖片、照片或其他支援的格式匯入 elDoc。
系統可在文件匯入時自動執行 OCR。
當文件準備好進入後續處理流程時,平台便可取得 OCR 識別出的內容。
上傳 → OCR → AI
使用者無須執行額外操作。
日常工作流程中無須再加入獨立的「執行 OCR」步驟。
文件匯入 elDoc 後,即可直接進入後續處理流程。
從 OCR 到 AI,無縫銜接
這正是整體架構發揮關鍵作用的地方。
OCR 不應是流程的終點。
它應成為後續所有處理流程背後的基礎,無須使用者額外介入。
文件內容經 OCR 識別後,即可供以下功能使用:
AI 資料擷取:擷取業務資訊,將文件內容轉換為結構化資料。
AI 文件分類:識別文件類型,並判斷適當的處理方式。
AI 分析:分析單份或整批文件,找出差異、模式、缺漏資訊,並解答其他業務問題。
Agentic RAG:從文件內容中擷取相關資訊,作為 AI 互動的背景脈絡。
AI 文件代理:讓 AI 代理在指定任務及工作流程中運用文件資訊。
企業搜尋:讓原本封存在掃描文件中的資訊也能被搜尋及查找。
工作流程自動化:根據識別及擷取的資訊,自動決定後續處理步驟。
關鍵在於,OCR 並非獨立於這套環境之外的功能。
它是整個文件生命週期的一部分。
文件只需匯入 elDoc 一次,其資訊便可供 OCR、資料擷取、AI、搜尋及自動化流程使用。
不同文件,需要不同的識別方式
但企業還面臨另一項挑戰。
企業文件並不存在一套適用所有情境的標準格式。
有些企業主要處理格式清晰的英文發票。
另一些企業則可能收到阿拉伯文申請表。
香港企業可能需要在同一環境中處理中文及英文文件。
跨國企業可能需要處理使用拉丁字母、西里爾字母、阿拉伯文、中文、日文及韓文的內容。
文件品質也是一項挑戰。
有些文件是清晰完整的數碼 PDF。
有些則是二十年前的掃描檔。
另一些以照片形式提交。
文件頁面可能出現旋轉、傾斜、變形或掃描不清等問題。
文件結構亦可能由簡單段落延伸至高度複雜的財務表格。
因此,若所有情境都依賴同一種識別技術,便可能難以滿足不同需求。
單一平台,整合多種 OCR 技術
elDoc 支援多種文件識別技術,而非依賴單一 OCR 引擎。企業可根據文件類型、語言、基礎架構、安全要求及 AI 應用場景,選擇最合適的識別方案。
| 技術 | 技術簡介 | 主要優勢 | 部署方式 | 適用場景 |
|---|---|---|---|---|
| Google Cloud Vision OCR | Google Cloud 提供的託管式 OCR 與電腦視覺服務,可偵測及識別圖片和文件中的文字。 | 支援多語言識別、可擴展的雲端處理,以及手寫文字和實際場景影像的識別。 | 雲端 | 重視擴展能力、廣泛語言支援及託管式雲端 OCR 的企業。 |
| PaddleOCR | 開源 OCR 工具套件,專為多語言文字及文件識別而設。 | 支援多種語言,具備文件版面分析及表格識別能力,並可靈活自訂。 | 地端部署/私有雲 | 需要靈活的多語言 OCR,同時要求所有處理均在受控基礎架構內進行的企業。 |
| Tesseract OCR | 成熟的開源 OCR 引擎,最初由 HP 開發,後由 Google 資助其發展。 | 架構輕量、應用廣泛、支援多種語言,並可完全離線運作。 | 地端部署/氣隙隔離環境 | 適用於重視簡易部署、內部處理及基礎架構自主控制的一般 OCR 工作。 |
| 視覺語言模型(VLM) | 可同時理解文件的視覺內容及自然語言的多模態 AI 模型。 | 不僅識別文字,還能理解文件結構、視覺脈絡、表格、欄位及資訊之間的關聯。 | 雲端或地端部署,視乎模型而定 | 適用於結構複雜或格式多變,且需要視覺理解及脈絡判讀的文件。 |
為何多種 OCR 技術至關重要
並不存在適用所有情境的「最佳」OCR 引擎。合適的技術取決於文件特性及業務需求。
大量清晰掃描文件的檔案庫,與包含多個表格及多種語言的複雜財務報表,可能需要不同的 OCR 方案。在隔離環境中運作的政府機構可能更重視全離線處理,而其他企業則可能優先考慮託管式雲端服務的擴展能力。
隨著 OCR 技術發展為文件 AI,選擇合適技術更顯重要。
傳統 OCR 主要回答:
「這一頁有哪些字元和文字?」
現代文件識別技術及視覺語言模型(VLM) 則能進一步回答更廣泛的問題:
「這一頁呈現了哪些資訊?這些資訊如何組織?」
對於包含複雜表格、不規則版面、視覺關聯、多種內容,以及意義取決於頁面位置的資訊的文件,這類能力尤其重要。
對於包含複雜表格、不規則版面、視覺關聯、多種內容,以及意義取決於頁面位置的資訊的文件,這類能力尤其重要。
elDoc 可根據企業需求配置文件識別層,無須讓所有文件都採用同一種技術處理。
雲端擴展能力 → Google Cloud Vision OCR
私有環境中的多語言處理 → PaddleOCR
離線及氣隙隔離環境中的 OCR → Tesseract OCR
複雜文件的視覺理解 → 視覺語言模型
核心原則很簡單:
OCR 架構應配合文件特性、安全要求及業務需求,而非要求企業遷就單一 OCR 引擎。
這亦進一步體現 elDoc 的整體價值:OCR 成為整合式文件識別層,而 AI 資料擷取、Agentic RAG 及 AI 文件代理則運用識別後的文件資訊執行各項任務。
識別結果也應反映不確定性
企業文件處理還有一個重要環節:判斷何時需要人工介入。
假設 AI 能以極高的信心度擷取發票編號,卻無法清楚識別低品質掃描檔中的金額。
這兩項結果不應一概而論。
在智能資料擷取過程中,elDoc 可為識別或擷取的欄位附上信心分數。
這些分數可作為業務流程的判斷依據。
信心度較高 → 自動繼續處理
信心度較低 → 要求核驗
企業無須要求員工逐一核對每份文件的所有欄位,而可在真正需要人工判斷的環節引入人機協作。
人員專注處理例外情況。
其餘工作則由系統根據預設規則及門檻自動處理。
在文件上建構 AI 應用前,先確保 AI 能讀取文件
新一代文件管理的核心,不再只是企業如何妥善儲存檔案。
真正的關鍵在於,企業能否有效地將檔案中的資訊轉化為AI 能夠理解並據以採取行動的內容。
OCR 是實現這一目標的第一道橋樑。
但 OCR 最能發揮效益的方式,是將其整合至既有流程,而非另設一套應用程式、額外的系統整合或人工操作步驟。
文件匯入 elDoc 後,OCR 即融入整個文件處理流程,支援多種格式、複雜版面、180 多種語言、多種 OCR 技術,以及從雲端到完全地端部署的不同模式。
最終成果很明確:
文件匯入 elDoc,資訊即可供 AI 運用。
探索 elDoc AI OCR 如何處理您的文件
歡迎攜帶您自己的文件樣本參加 elDoc 示範,親身了解平台如何處理您所使用的文件格式、語言、版面及實際業務中的文件挑戰,以及如何將識別後的資訊直接交由 AI 進一步處理。