ШІ починається з OCR: основа інтелектуального опрацювання документів
Управління корпоративними документами стрімко змінюється.
Організації впроваджують RAG, пошук за допомогою ШІ, ШІ-агентів для роботи з документами, інтелектуальне вилучення даних і генеративний ШІ для роботи з архівами, що містять мільйони документів.
Мета очевидна: замість простого зберігання документів організації прагнуть ставити запитання, отримувати потрібні дані, виявляти ризики, зіставляти документи й автоматизувати робочі процеси за допомогою ШІ.
Однак існує фундаментальна проблема, яку напрочуд легко не помітити.
ШІ не може надійно працювати з інформацією, яку не здатен зчитати.
Значна частина корпоративної інформації досі надходить у вигляді сканованих PDF-файлів, зображень, сфотографованих документів, архівних матеріалів, заяв, сертифікатів, виписок та іншого контенту у графічному форматі.
PDF-файл може бути цілком читабельним для людини, але фактично не містити тексту, доступного для машинного зчитування, або містити його лише частково.
Можна побудувати на цій основі сучасну архітектуру RAG, під’єднати LLM і впровадити ШІ-агентів.
Але спочатку хтось або щось має зчитати вміст документа.
Саме тому OCR стає основою інтелектуальної роботи з документами (Document AI).
Ефективність ШІ залежить від якості даних у документах
Уявімо організацію, яка зберігає в електронному архіві документи за останні десять років.
Це договори, рахунки, заявки клієнтів, платіжні повідомлення, ділове листування, сертифікати, виписки та скановані архівні документи.
Тепер організація впроваджує ШІ-асистента.
Користувач ставить запитання:
«Знайди всі платіжні повідомлення, у яких сума не відповідає даним у підтвердних документах, і визнач найсуттєвіші розбіжності».
На перший погляд, це завдання для ШІ.
І зрештою так воно і є.
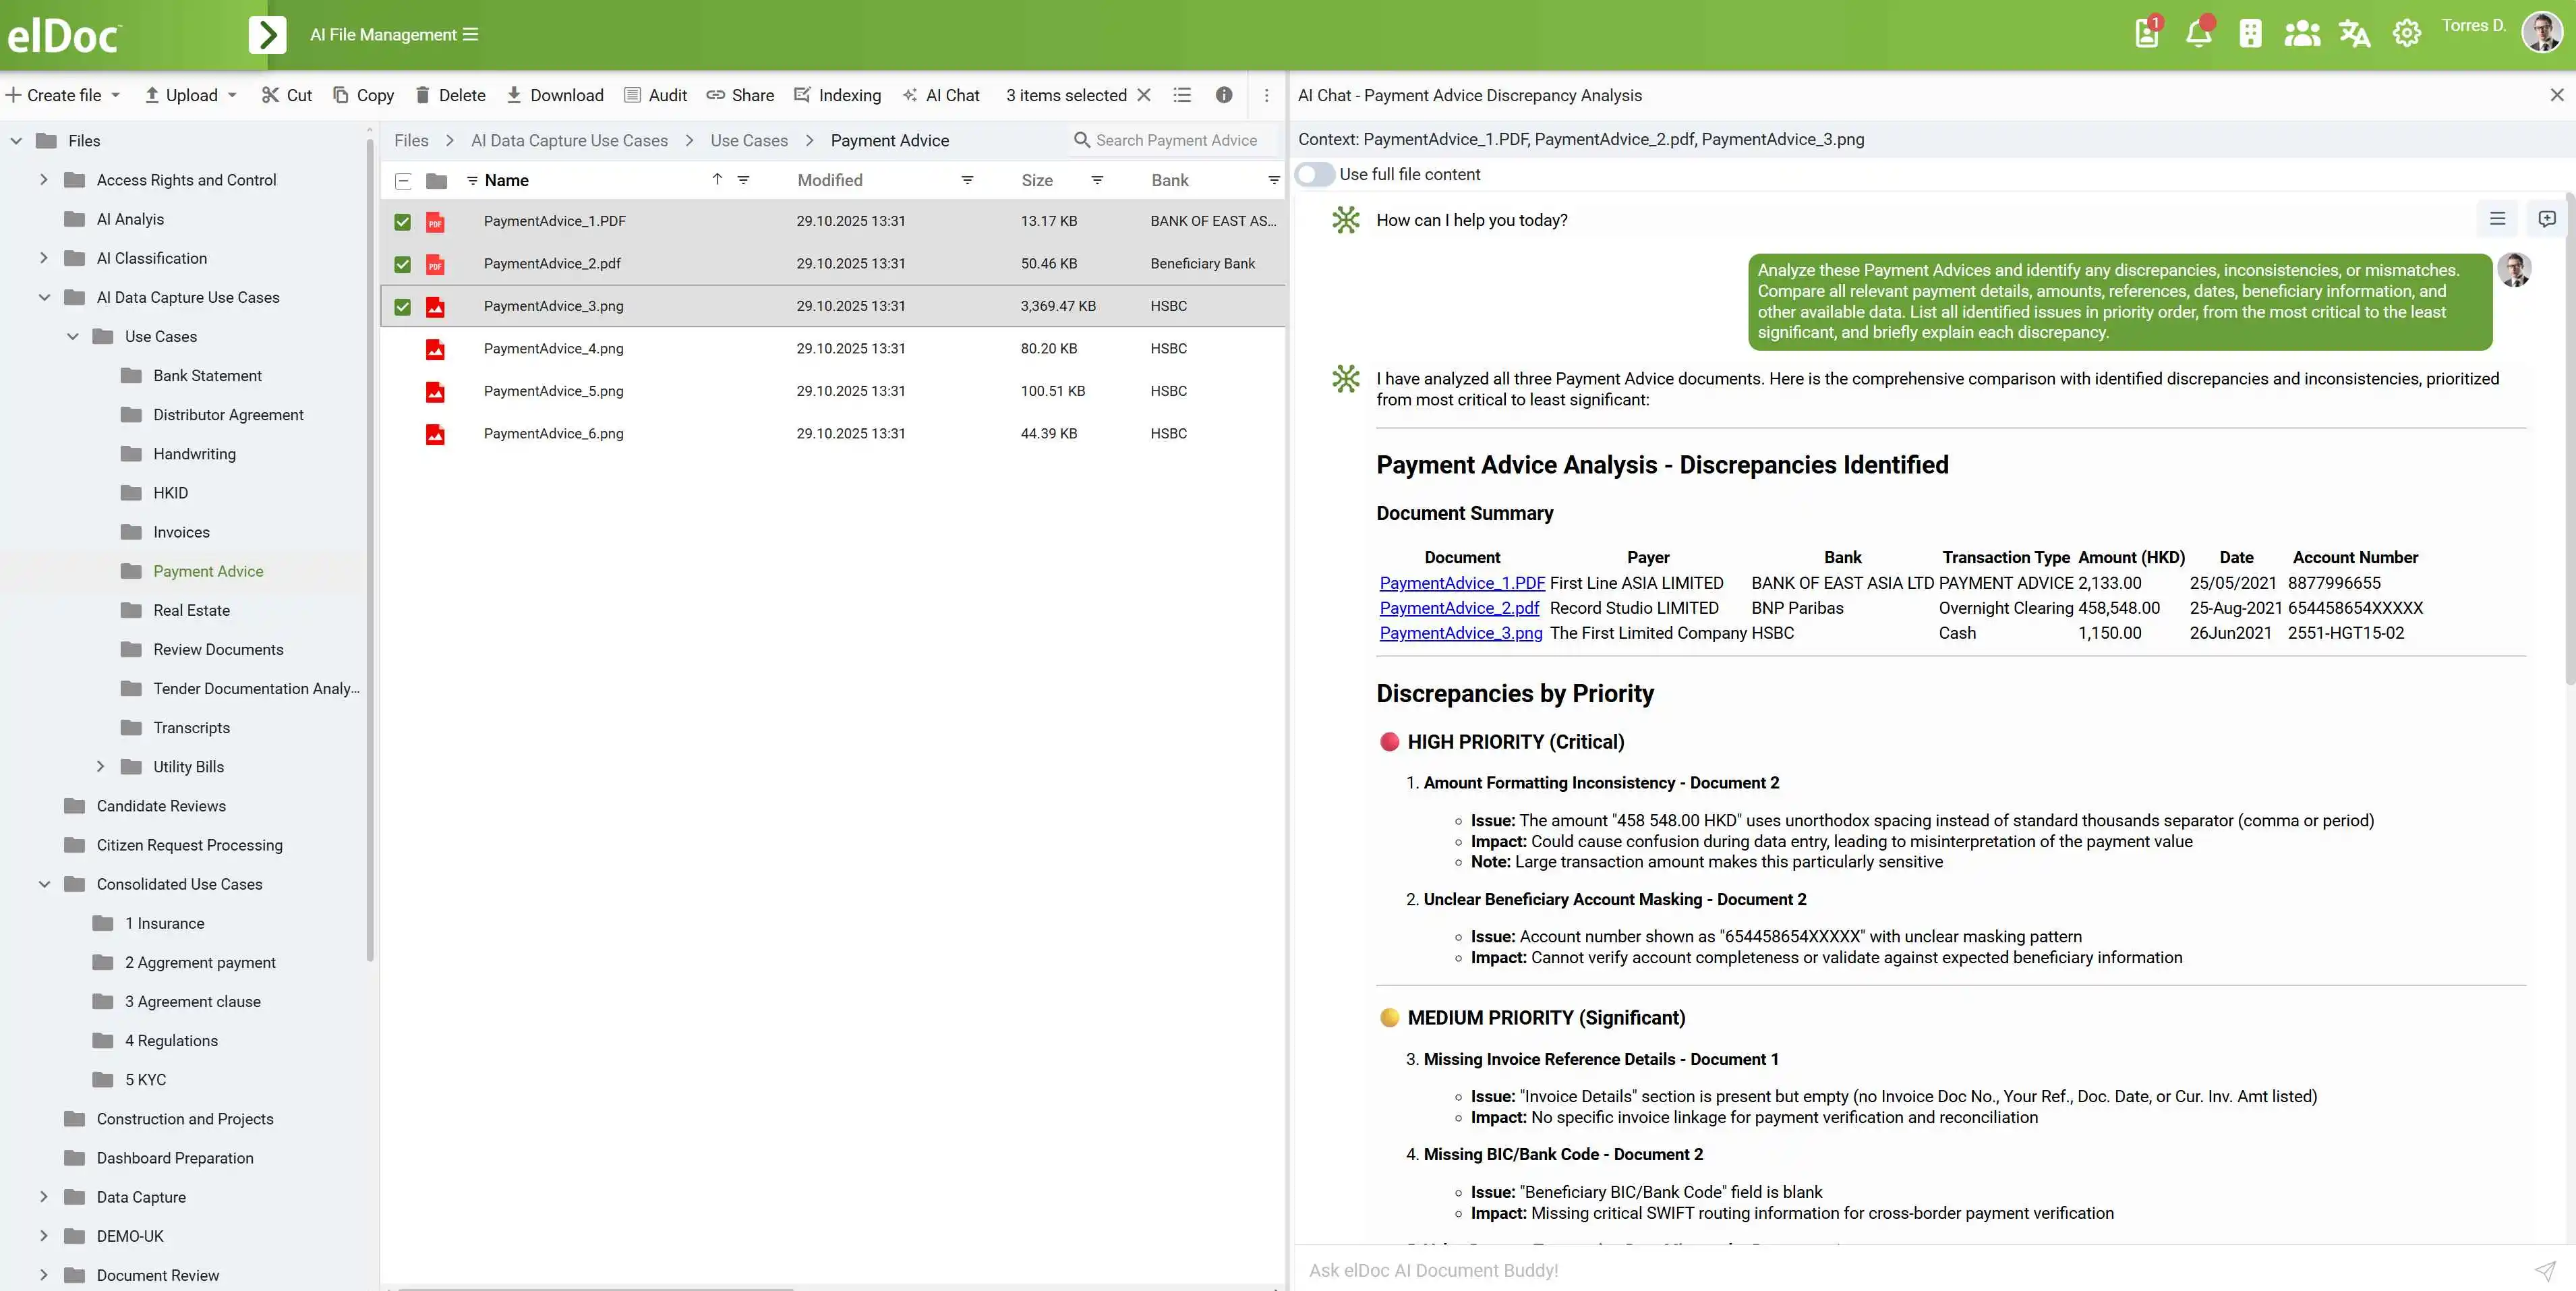
Але перш ніж LLM зможе проаналізувати ці документи, RAG – знайти релевантні фрагменти, а ШІ-агент для роботи з документами – зіставити інформацію, документи мають стати доступними для машинного зчитування.
У документах, створених у цифровому форматі та забезпечених повноцінним текстовим шаром, ця умова вже може бути виконана.
Однак скановані документи та зображення часто не мають такого текстового шару.
Саме OCR усуває цю перешкоду.
Чому OCR не варто розглядати як окремий етап
У багатьох системах управління документами OCR досі залишається окремим процесом.
Надходить документ.
Користувач завантажує його в систему.
Інший сервіс розпізнає текст.
Отриманий файл або розпізнаний текст потрібно передати, проіндексувати чи синхронізувати.
Лише після цього можна розпочинати вилучення даних, пошук, роботу RAG або опрацювання за допомогою ШІ.
Такий підхід був виправданим, коли основним завданням OCR було створення PDF-файлів з можливістю пошуку.
Однак він стає менш доцільним, коли організації прагнуть забезпечити безперервну роботу ШІ з документами.
Документ уже надійшов до вашої системи. Навіщо пропускати його через ще один ізольований етап опрацювання, перш ніж ШІ зможе з ним працювати?
elDoc пропонує інший підхід.elDoc takes a different approach.
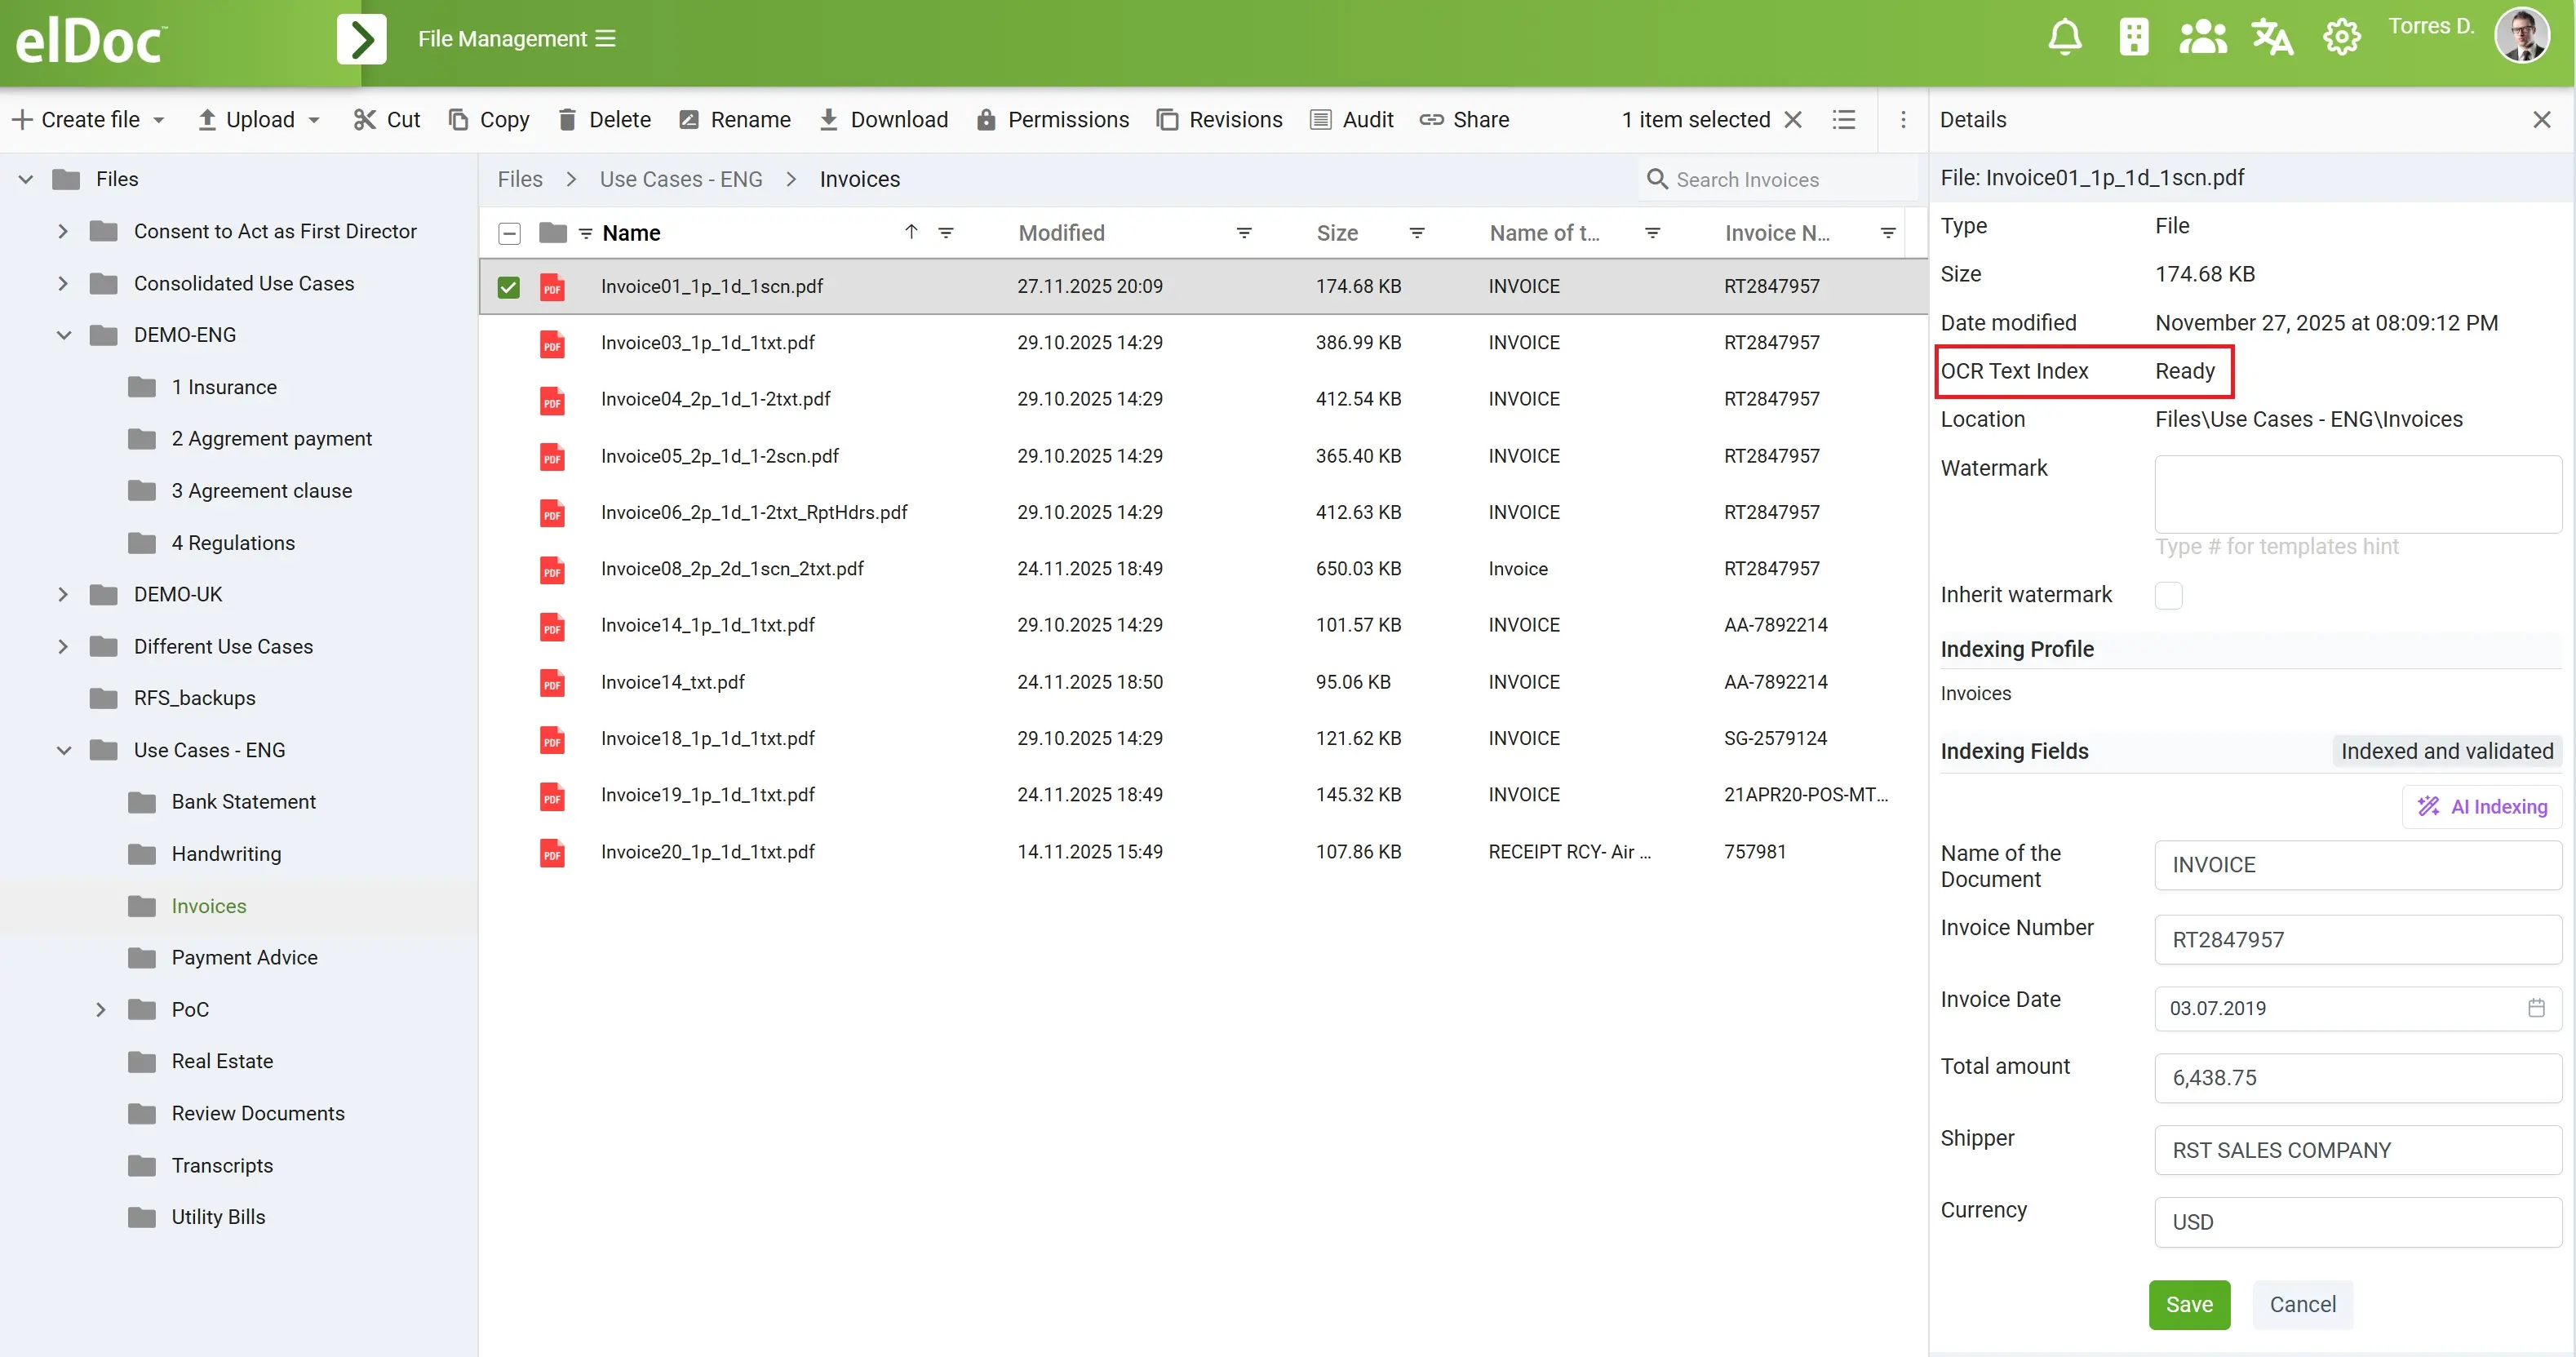
OCR запускається під час надходження документа в elDoc
Користувачеві не потрібно запускати окремий процес OCR.
Документ надходить до elDoc у форматі PDF, сканованої копії, зображення, фотографії або іншому підтримуваному форматі.
OCR може виконуватися автоматично під час завантаження документа в систему.
Ще до початку подальшого опрацювання розпізнаний текст документа вже може бути доступний платформі.
Завантаження → OCR → ШІ
Від користувача не потрібно жодних додаткових дій.
Не потрібно додавати до щоденних робочих процесів окремий етап «Запустити OCR».
Документ просто надходить до elDoc і стає доступним для подальшої роботи.
Від OCR до ШІ – природний перехід
Саме тут архітектура рішення набуває вирішального значення.
OCR не повинен бути кінцевою метою.
Він має стати непомітною основою для всіх подальших процесів.
Після розпізнавання вміст документа одразу стає доступним для:
Вилучення даних за допомогою ШІ (AI Data Extraction) – отримання ділової інформації та перетворення вмісту документів на структуровані дані.
Класифікації документів за допомогою ШІ (AI Document Classification) – визначення типу документа та способу його подальшого опрацювання.
Аналізу за допомогою ШІ (AI Analysis) – виявлення розбіжностей, закономірностей, відсутньої інформації та пошук відповідей на інші бізнес-запити як в окремих документах, так і в їх сукупності.
Agentic RAG – пошук релевантної інформації у вмісті документів та використання її як контексту для взаємодії із ШІ.
ШІ-агентів для роботи з документами (AI Document Agents) – опрацювання документної інформації в межах визначених завдань і робочих процесів за допомогою ШІ-агентів.
Корпоративного пошуку (Enterprise Search) – пошук інформації, яка раніше залишалася недоступною всередині сканованих документів.
Автоматизації робочих процесів (Workflow Automation) – використання розпізнаної та вилученої інформації для визначення подальших дій.
Принципова відмінність полягає в тому, що OCR не є зовнішнім щодо цієї системи процесом.
Він є невіддільною частиною єдиного життєвого циклу документа.
Документ достатньо один раз завантажити в elDoc. Після цього його вміст стає доступним для розпізнавання тексту, вилучення даних, роботи ШІ, пошуку й автоматизації.
Не всі документи однакові
Однак є й інша проблема.
У корпоративному середовищі не існує універсального формату документів.
Одна організація може переважно опрацьовувати якісно оформлені рахунки англійською мовою.
Інша – отримувати заявки арабською мовою.
Підрозділ у Гонконзі може працювати з документами китайською та англійською мовами в межах однієї системи.
Міжнародна компанія може потребувати опрацювання документів з текстом латиницею, кирилицею, арабським, китайським, японським і корейським письмом.
Не менш важливою є якість самих документів.
Одні документи – це бездоганні цифрові PDF-файли.
Інші – скановані копії двадцятирічної давності.
Частина документів надходить у вигляді фотографій.
Сторінки можуть бути повернутими, перекошеними, деформованими або неякісно відсканованими.
Структура документів також може варіюватися від простого текстового абзацу до складних фінансових таблиць.
Саме тому використання одного методу розпізнавання для всіх типів документів і сценаріїв може обмежувати можливості системи.
Єдина платформа. Кілька технологій OCR
elDoc підтримує різні технології розпізнавання документів, а не покладається на один механізм OCR. Це дає змогу організаціям обирати оптимальний підхід до розпізнавання з огляду на типи документів, мови, інфраструктуру, вимоги до безпеки та сценарії використання ШІ.
| Технологія | Опис | Основні переваги | Розгортання | Оптимальні сценарії використання |
|---|---|---|---|---|
| Google Cloud Vision OCR | Керований хмарний сервіс Google Cloud для комп’ютерного зору, виявлення та розпізнавання тексту на зображеннях і в документах. | Висока точність багатомовного розпізнавання, масштабоване хмарне опрацювання, підтримка рукописного тексту та розпізнавання тексту на реальних зображеннях. | Хмарне середовище | Організації, для яких пріоритетами є масштабованість, широка мовна підтримка та використання керованого хмарного OCR-сервісу. |
| PaddleOCR | Інструментарій OCR із відкритим вихідним кодом для багатомовного розпізнавання тексту й документів. | Широка мовна підтримка, розпізнавання структури документів і таблиць, гнучкі можливості налаштування. | Власна інфраструктура (on-premises) / приватна хмара | Компанії, яким потрібне гнучке багатомовне розпізнавання тексту зі збереженням усіх процесів опрацювання в контрольованій інфраструктурі. |
| Tesseract OCR | Перевірений часом механізм OCR із відкритим вихідним кодом, спочатку розроблений компанією HP, а згодом підтриманий Google. | Невибагливий до ресурсів, широко використовуваний, підтримує багато мов і може працювати повністю автономно, без підключення до інтернету. | Власна інфраструктура (on-premises) / ізольоване середовище (air-gapped) | Типові завдання розпізнавання тексту, для яких пріоритетами є простота, локальне опрацювання та контроль над інфраструктурою. |
| Візуально-мовні моделі (Vision-Language Models, VLMs) | Мультимодальні моделі ШІ, здатні аналізувати як візуальний вміст документів, так і природну мову. | Не обмежуються розпізнаванням символів, а й дають змогу аналізувати структуру документа, візуальний контекст, таблиці, поля та взаємозв’язки між даними. | Хмарне середовище або власна інфраструктура (on-premises) – залежно від моделі | Складні документи з нестандартною або мінливою структурою, для опрацювання яких важливі розуміння візуального контексту та інтерпретація інформації. |
Чому важливо підтримувати різні технології
Не існує універсального механізму OCR, який був би найкращим для всіх випадків. Вибір технології залежить від типу документа та конкретних бізнес-завдань.
Для масштабного архіву якісних сканованих документів може бути доцільним один підхід до OCR, а для складної фінансової звітності з численними таблицями та кількома мовами – інший. Державна установа, що працює в ізольованому середовищі, може надавати перевагу повністю автономному опрацюванню без підключення до мережі, тоді як інша компанія – масштабованості керованого хмарного сервісу.
Ця відмінність набуває ще більшого значення в міру розвитку OCR у напрямі інтелектуального опрацювання документів (Document AI).
Традиційний OCR передусім відповідає на запитання:
«Які символи та слова містяться на цій сторінці?»
Сучасні технології розпізнавання документів і VLMs дедалі краще дають змогу відповісти на ширше запитання:
«Яку інформацію містить ця сторінка та як її структуровано?»
Це особливо важливо для документів зі складними таблицями, нестандартним компонуванням, візуальними взаємозв’язками, різнорідним вмістом, а також інформацією, значення якої залежить від її розташування на сторінці.
Обирайте технологію розпізнавання відповідно до завдань
elDoc дає змогу адаптувати рівень розпізнавання до потреб компанії, а не обмежувати опрацювання всіх документів однією технологією.
Масштабоване хмарне опрацювання → Google Cloud Vision OCR
Захищене багатомовне опрацювання у власній інфраструктурі → PaddleOCR
Автономне розпізнавання в ізольованому середовищі → Tesseract OCR
Аналіз складних документів з розумінням їхнього візуального контексту → візуально-мовні моделі (VLMs)
Загальний принцип простий:
Архітектура OCR має відповідати типам документів, вимогам безпеки та бізнес-завданням, а не змушувати компанію пристосовуватися до одного механізму розпізнавання.
Це також підсилює загальну ціннісну пропозицію elDoc: OCR стає інтегрованим рівнем розпізнавання, на основі результатів якого працюють вилучення даних за допомогою ШІ, Agentic RAG та ШІ-агенти для роботи з документами.
Розпізнавання має також визначати рівень достовірності результатів
Ще один важливий аспект опрацювання корпоративних документів – здатність визначати, коли автоматизація потребує втручання людини.
Наприклад, ШІ може розпізнати номер рахунку з високою впевненістю, але невиразно зчитати суму з неякісного скану.
Очевидно, що до цих двох результатів не варто застосовувати однаковий підхід.
Під час інтелектуального вилучення даних elDoc може визначати рівень упевненості для кожного розпізнаного або вилученого поля.
Ці показники можна використовувати безпосередньо в бізнес-процесах.
Високий рівень упевненості → автоматичне продовження опрацювання
Низький рівень упевненості → запит на перевірку
Замість того щоб доручати працівникам перевірку кожного поля в кожному документі, організації можуть залучати людей до опрацювання лише там, де це справді підвищує якість результату.
Працівники зосереджуються на нестандартних випадках.
Решту завдань система виконує автоматично відповідно до налаштованих правил і порогових значень.
Перш ніж впроваджувати ШІ для роботи з документами, переконайтеся, що він може їх зчитувати
Майбутнє управління документами визначатиметься не лише тим, наскільки ефективно організації зберігають файли.
Вирішальним стане те, наскільки ефективно вони зможуть перетворювати інформацію з документів на дані, які ШІ здатен розуміти та використовувати для виконання завдань.
OCR – перший крок до цього.
Однак найбільшу користь він приносить тоді, коли не потребує окремого застосунку, додаткової інтеграції чи ручного втручання.
У elDoc OCR інтегрований у процес опрацювання документа від моменту його надходження до платформи – незалежно від формату, складності структури, мови (підтримується понад 180 мов), технології розпізнавання чи моделі розгортання – від хмарного середовища до повністю локальної інфраструктури (on-premises).
Результат простий:
Документи надходять до elDoc. Інформація з них стає доступною для ШІ.
Оцініть можливості elDoc AI OCR на практиці
Надайте зразки своїх документів під час демо elDoc. Переконайтеся, як платформа розпізнає різні формати й мови, опрацьовує складну структуру документів і використовує отримані дані в процесах на базі ШІ.