結合 LLM 的開源 AI 文件處理:深入了解 elDoc 的架構與技術組合
開源技術大幅加快了 AI 文件處理技術的發展。OCR 引擎、文件解析函式庫、大型語言模型(LLM)及 AI 整合框架,現已為開發人員提供強大的工具,讓他們能夠從文件中擷取資訊並理解其內容。
然而,能夠使用個別技術,與擁有一套完整且可實際投入運作的智能文件處理(IDP)方案,兩者之間存在重要分別。
許多開源專案只專注於特定功能,例如文字識別、PDF 解析、文件格式轉換或 AI 模型整合。若要以這些元件建構可實際運作的文件處理應用程式,通常仍需額外開發使用者介面、處理流程、資料儲存、文件分類、驗證工作流程及系統整合功能。
elDoc 採取了不同的方案。
隨着 elDoc IDP OSS 於 2026 年 11 月 8 日正式開源,elDoc 將其智能文件處理模組開放予開源社群使用。該模組是 elDoc GenAI 文件智能平台的重要組成部分。
elDoc IDP OSS 並非另一套獨立的 SDK、OCR 函式庫或開發工具套件,而是一套整合式、可直接部署的應用程式,內置網頁使用者介面、可配置的 AI 模型、文件處理工作流程、持久化儲存功能,以及人工參與的驗證機制(Human-in-the-Loop)。
此方案建基於企業級文件自動化技術,充分體現 elDoc 在大規模文件處理環境中的實踐經驗,涵蓋政府機構、公營機構及每年處理數十萬份文件的大型企業。
本文將深入介紹 elDoc IDP OSS 背後採用的技術、系統架構及運作方式,以及企業如何善用這項開源方案創造實際價值。
1. elDoc 開源智能文件處理方案包含哪些功能?
elDoc IDP OSS 提供端到端的文件處理應用程式,運用 OCR 與生成式 AI,將 PDF、掃描文件及圖像轉化為結構化、可供業務應用的資訊。
此應用程式整合了執行智能文件處理工作流程所需的核心功能:
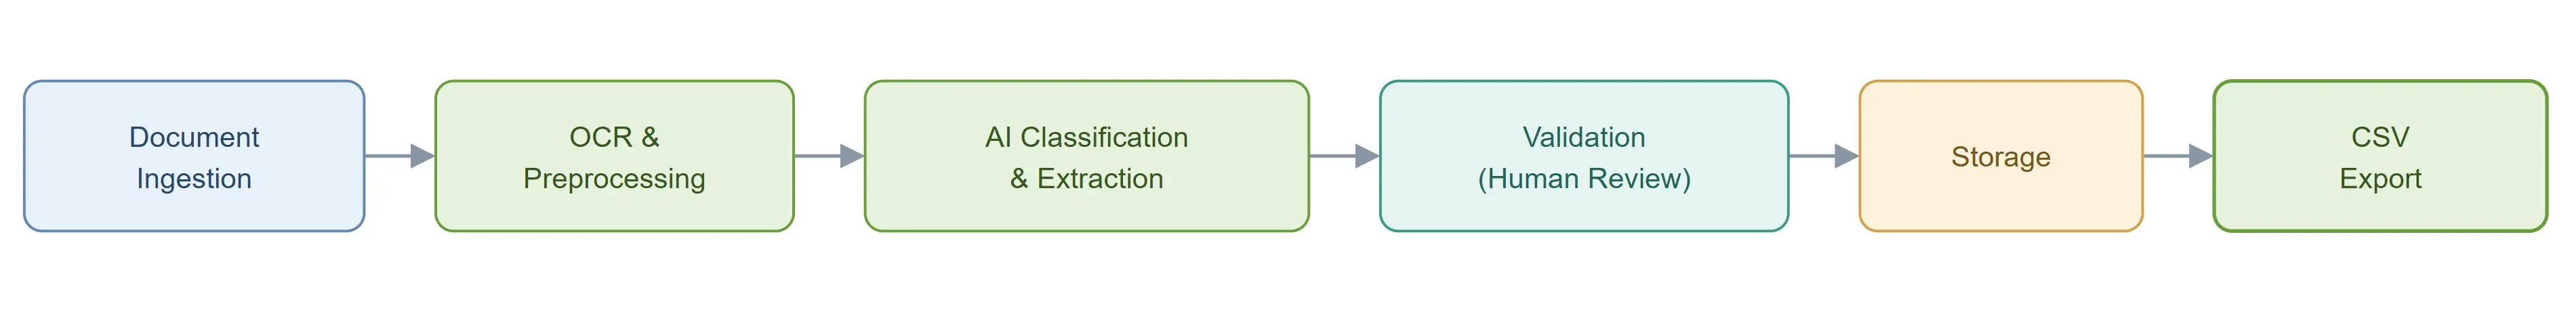
- 文件匯入: 上載 PDF、掃描文件、圖像及支援的多頁文件格式。
- OCR 與前處理: 識別文字、處理文件圖像,並擷取內容以供 AI 分析。
- AI 文件分類: 利用已配置的大型語言模型識別文件類型並進行分類。
- 基於 LLM 的資料擷取: 將相關業務資訊擷取至結構化欄位。
- 人工參與驗證: 透過整合式網頁介面審閱、核實及修正 AI 擷取的資訊。
- 持久化儲存: 使用 MongoDB 儲存應用程式資料及文件處理資訊。
- 結構化資料匯出: 將已驗證的資訊匯出為 CSV 檔案,以便進一步處理。
所有功能均整合於同一應用程式內,無須開發人員自行整合多個獨立軟件專案。
關鍵分別在於: elDoc 提供的是一套可實際運作的 IDP 應用程式,而不只是用來自行開發此類應用程式的技術元件。
2. 技術架構:驅動 elDoc IDP OSS 的核心技術
elDoc IDP OSS 整合成熟的企業級 Java 技術、開源文件識別引擎、資料庫基礎架構,以及可靈活配置的 AI 模型整合方案。
| 技術 | 在 elDoc IDP OSS 中的用途 |
|---|---|
| Java 21 | 核心應用程式開發及文件處理服務 |
| Jakarta EE | 企業級應用程式架構 |
| Payara Micro | Java 應用程式執行環境 |
| Jakarta Faces / PrimeFaces | 內置網頁使用者介面 |
| MongoDB | 應用程式持久化儲存、文件中繼資料及處理資訊 |
| Tesseract OCR | 內置 OCR 文字識別功能 |
| PaddleOCR | 用於文件識別的另一款 OCR 引擎 |
| OpenCV / Bytedeco | 圖像前處理及電腦視覺整合 |
| Apache PDFBox | PDF 處理及文件操作 |
| TwelveMonkeys ImageIO | 支援更多圖像格式 |
| LangChain4j | 透過 Java 整合大型語言模型(LLM) |
| OpenRouter | 透過統一 API 存取支援的 AI 模型 |
| AWS Bedrock | 整合託管式基礎模型 |
| 相容 OpenAI API 的端點 | 連接相容的 AI 服務及模型伺服器 |
| 本地託管的 LLM | 在機構自有的基礎架構內進行 AI 處理 |
這套技術架構為文件密集型應用程式提供穩固基礎,同時讓企業按實際需求靈活配置不同的 OCR 技術及 AI 處理方案。
為何選用 Java?
Java 21 與 Jakarta EE 構成 elDoc 應用程式架構的核心基礎。
對企業 IT 團隊而言,Java 擁有成熟且熟悉的技術生態系統,便於開發、部署及維護應用程式,並與現有業務系統整合。
結合 Payara Micro,elDoc IDP OSS 將文件處理服務及應用程式功能整合至可部署的 Java 執行環境中。
與必須嵌入其他軟件產品才能使用的 Java SDK 不同,elDoc IDP OSS 已內置執行文件處理工作流程所需的應用程式邏輯及使用者介面,可獨立投入運作。
3. 端到端文件處理流程如何運作
elDoc IDP OSS 的核心功能之一,是整合式文件處理流程。
此流程將文件匯入、OCR、AI 文件分類、結構化資料擷取、人工驗證及資料匯出整合為一套協調運作的完整流程。
步驟 1 — 文件匯入
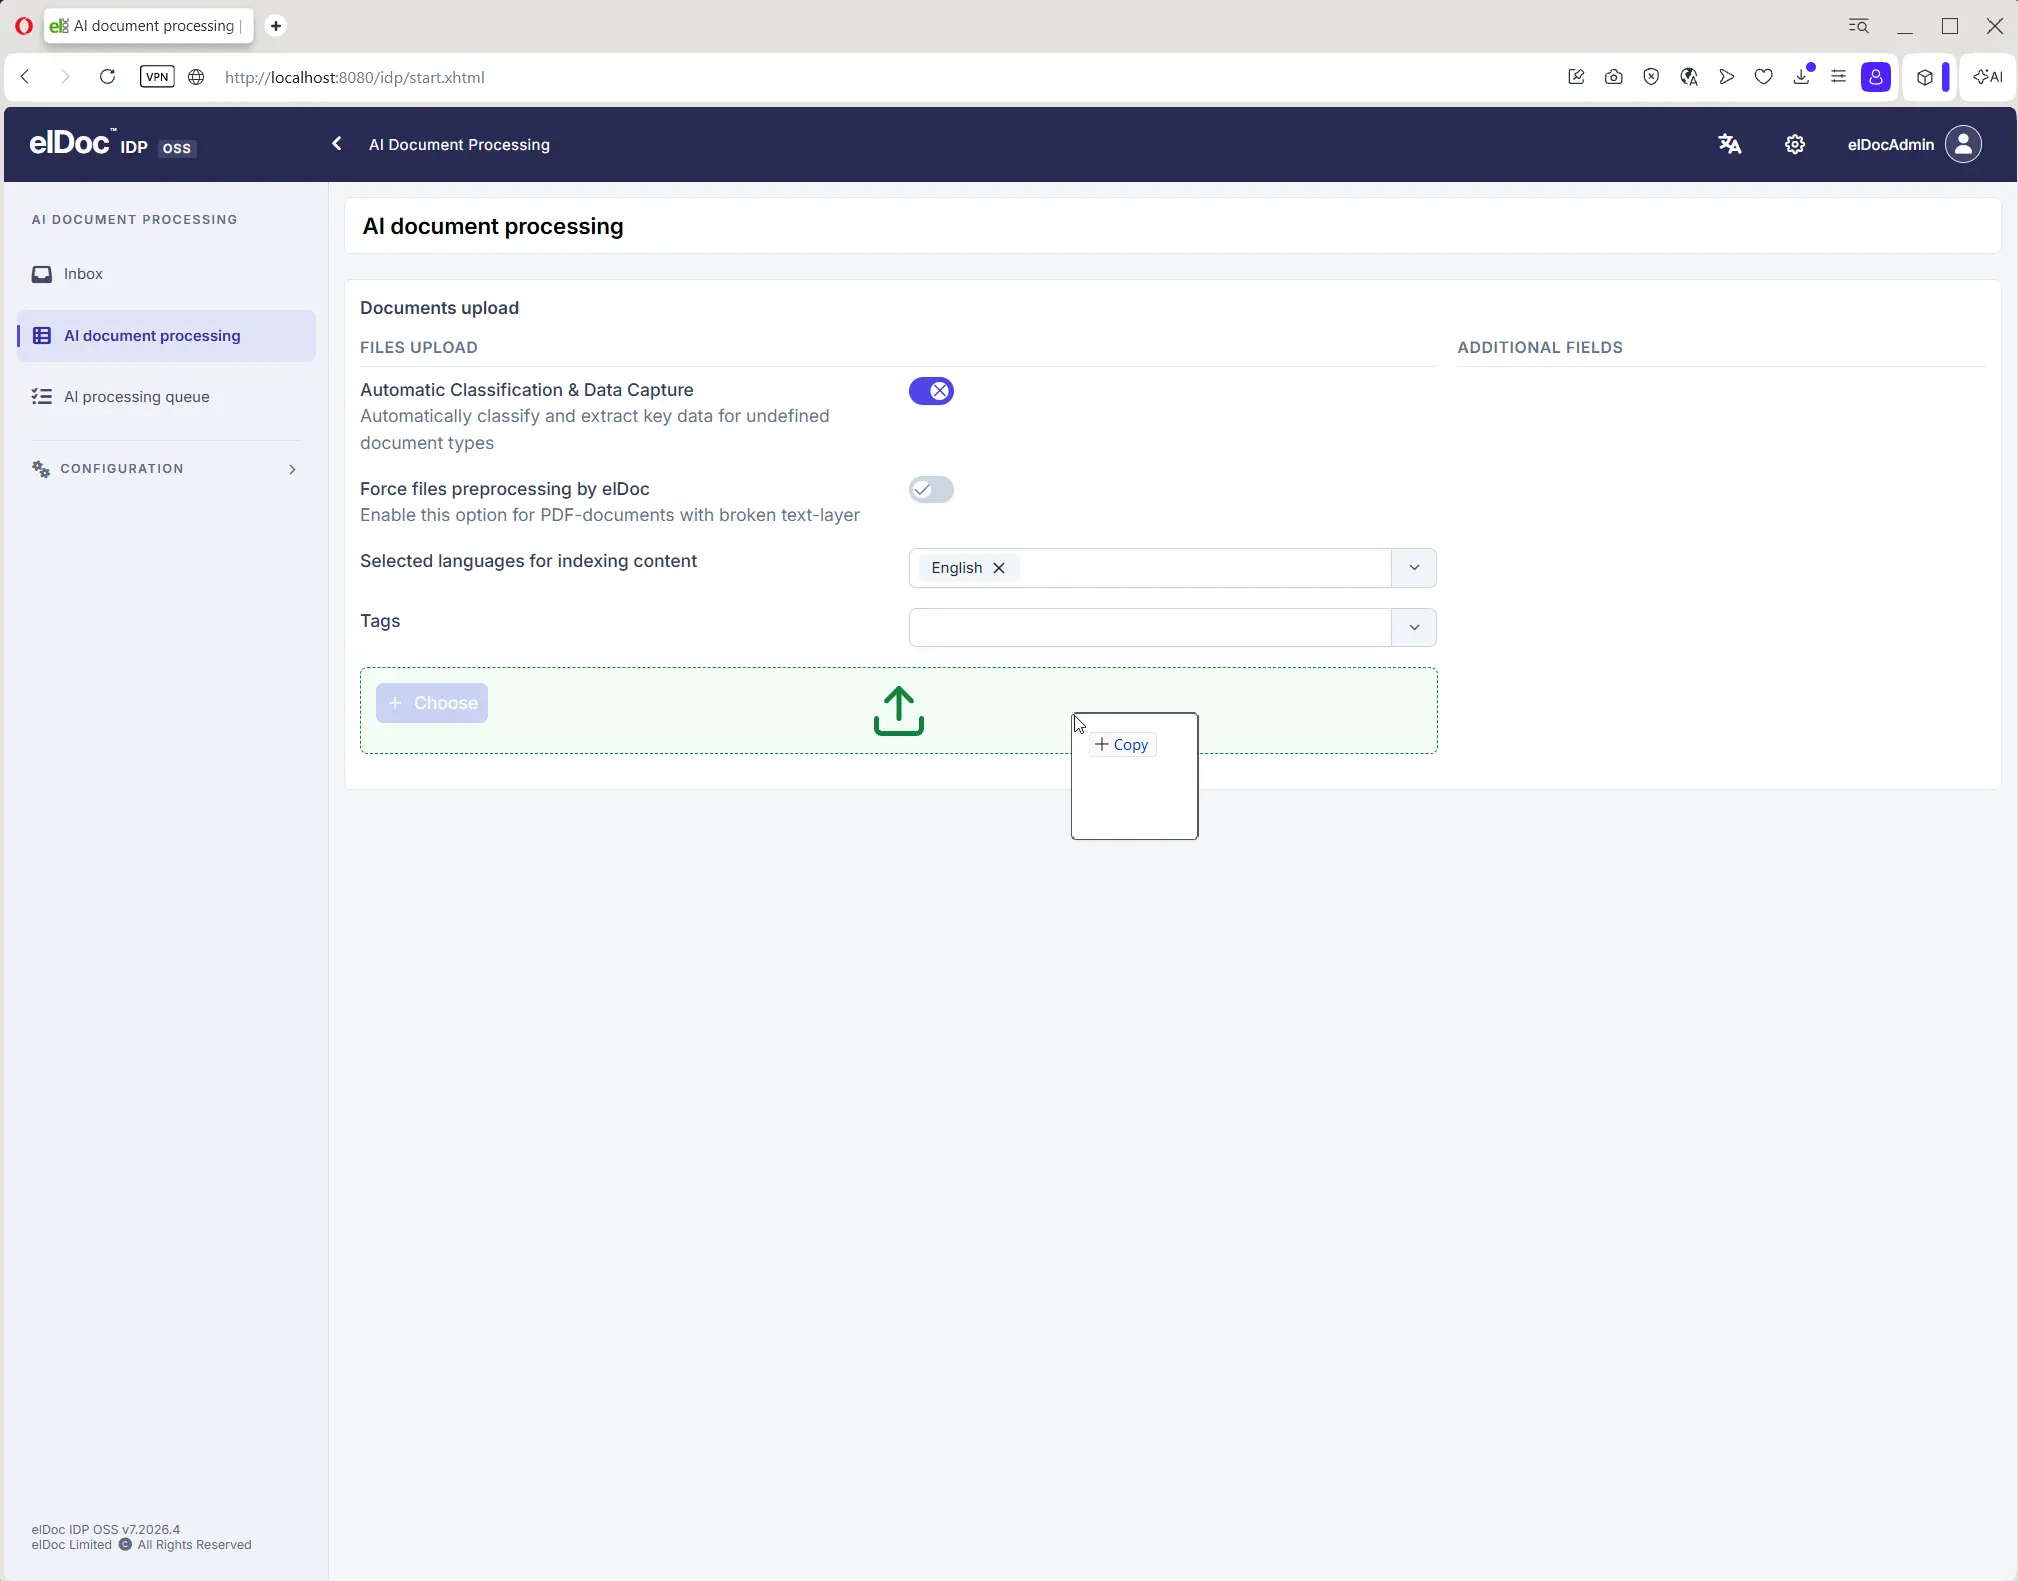
使用者可透過內置網頁介面上載 PDF、掃描文件、圖像或支援的多頁 TIFF 檔案。
應用程式會預先處理上載內容,以便進行後續文字識別及 AI 分析。
步驟 2 — OCR 與圖像前處理
在使用生成式 AI 處理文件之前,可能需要先進行圖像前處理及文字識別。
elDoc 支援多種 OCR 技術,包括 Tesseract 和 PaddleOCR,亦支援視覺語言模型(VLM)的處理能力。
圖像處理技術會透過影像標準化、旋轉校正及傾斜修正等操作,改善文件圖像品質,為後續處理做好準備。
此階段會將文件中的視覺內容轉換為可供後續 AI 元件處理的資訊。
步驟 3 — AI 文件分類
大型語言模型會分析文件內容,識別其類型及所屬類別。
對於需要處理多種文件的企業而言,這項功能尤其實用,例如發票、合約、財務紀錄、申請表格及商業往來文件。
完成分類後,系統便可根據識別出的文件類型,採用相應的資料擷取邏輯。
步驟 4 — 利用 LLM 智能擷取資料
完成分類後,已配置的 LLM 會從文件內容中擷取相關資訊。
有別於完全依賴固定範本或預設文件座標的傳統方式,LLM 資料擷取技術能夠理解文件內容,並從不同版面配置中識別所需資訊。
可擷取的資訊包括發票編號、供應商名稱、日期、金額、合約資料,以及其他業務所需欄位。
使用者可根據實際處理需求,自行配置需要擷取的資訊項目。
實際應用案例:
ATM 交易收據: 從不同銀行及 ATM 網絡發出的交易收據中,擷取交易日期、金額、貨幣、ATM 識別碼、交易參考編號及其他財務資料。
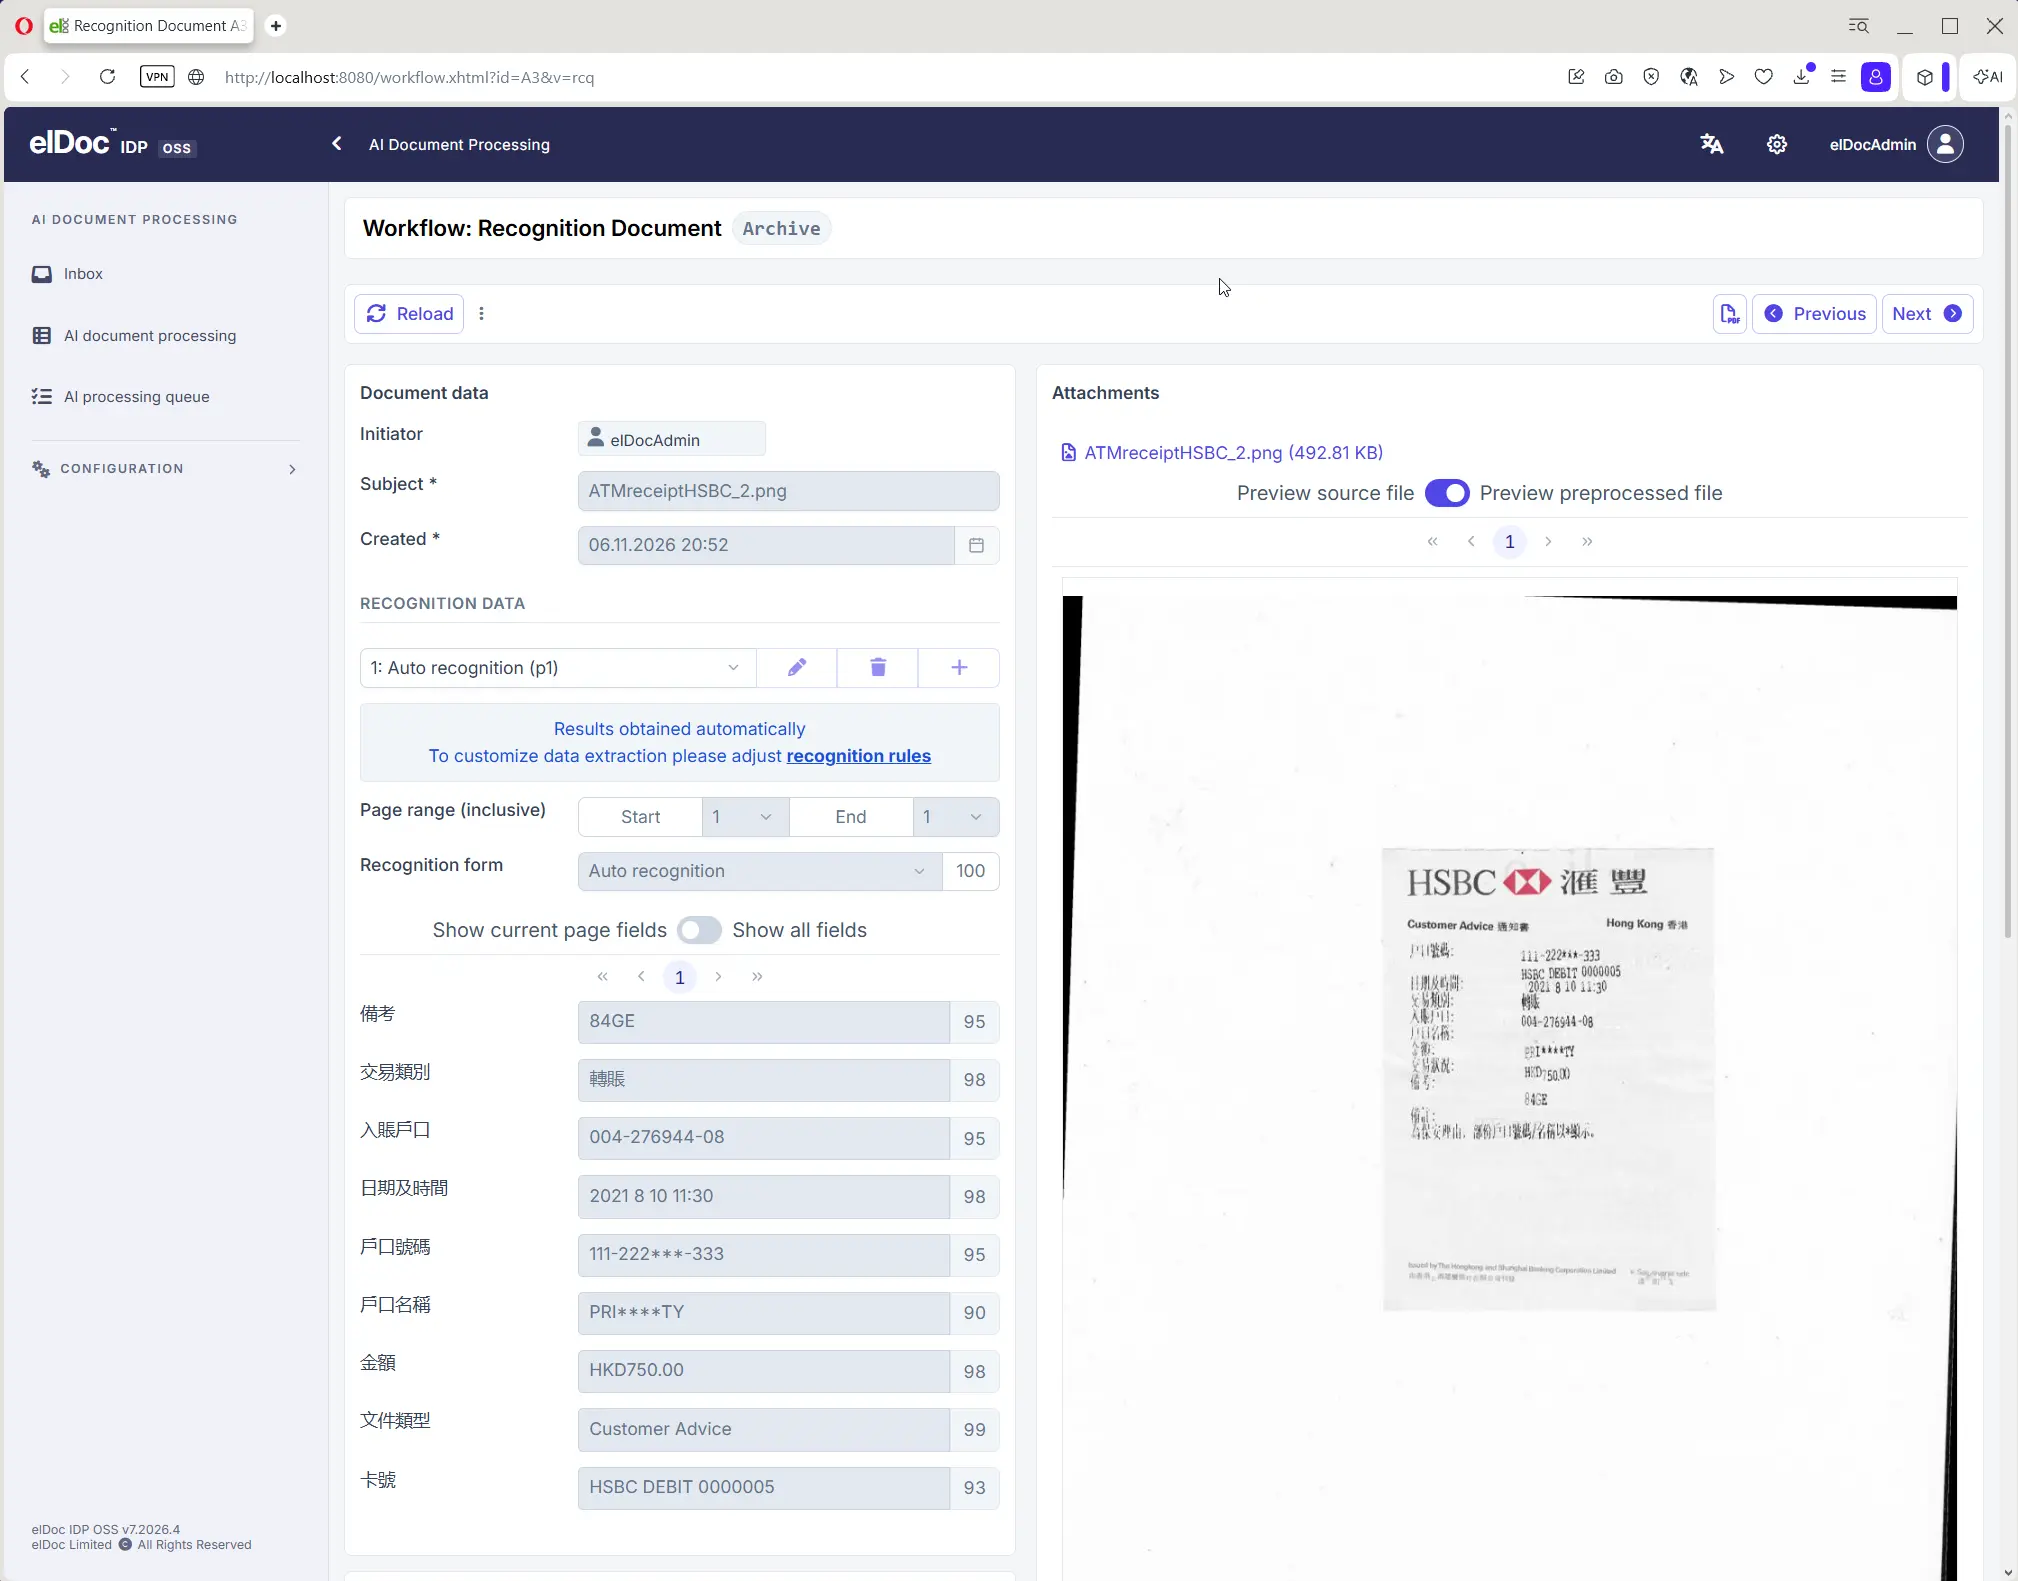
實際應用案例:
公用事業賬單: 從不同公用事業供應商發出的賬單中,擷取客戶資料、賬戶號碼、計費週期、電力、燃氣及用水量、應繳金額及付款期限。
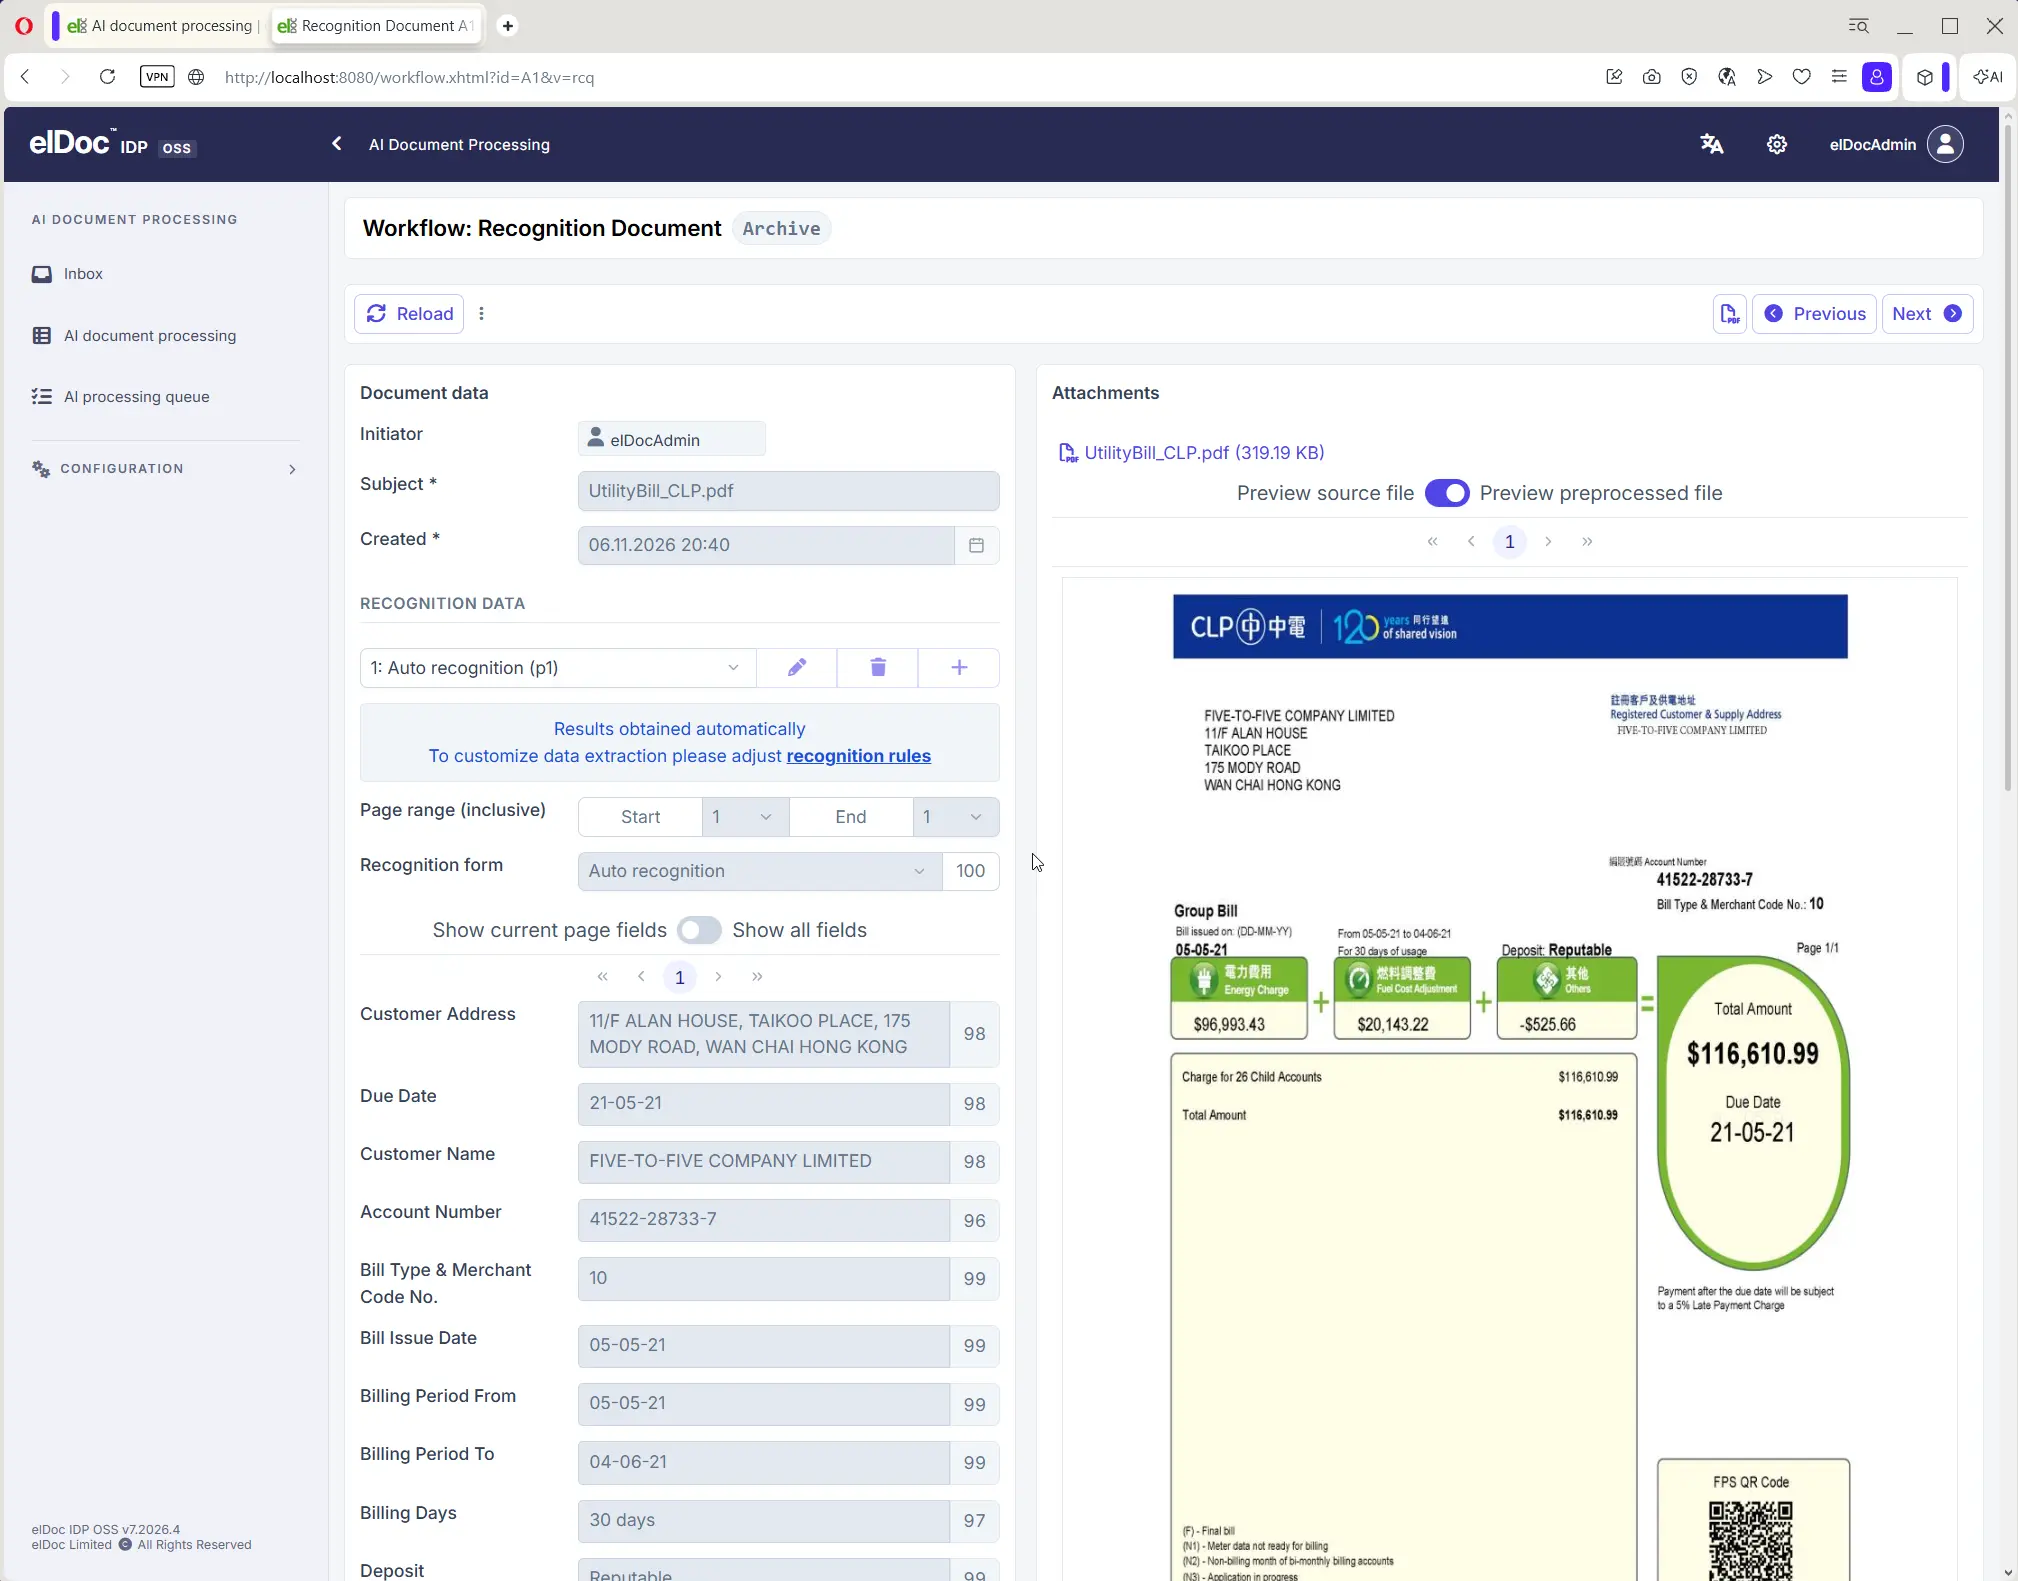
實際應用案例:
申請表格: 從政府、銀行、保險及企業申請表格中,擷取申請人資料、身份識別資訊、地址、申請服務項目及其他相關欄位。
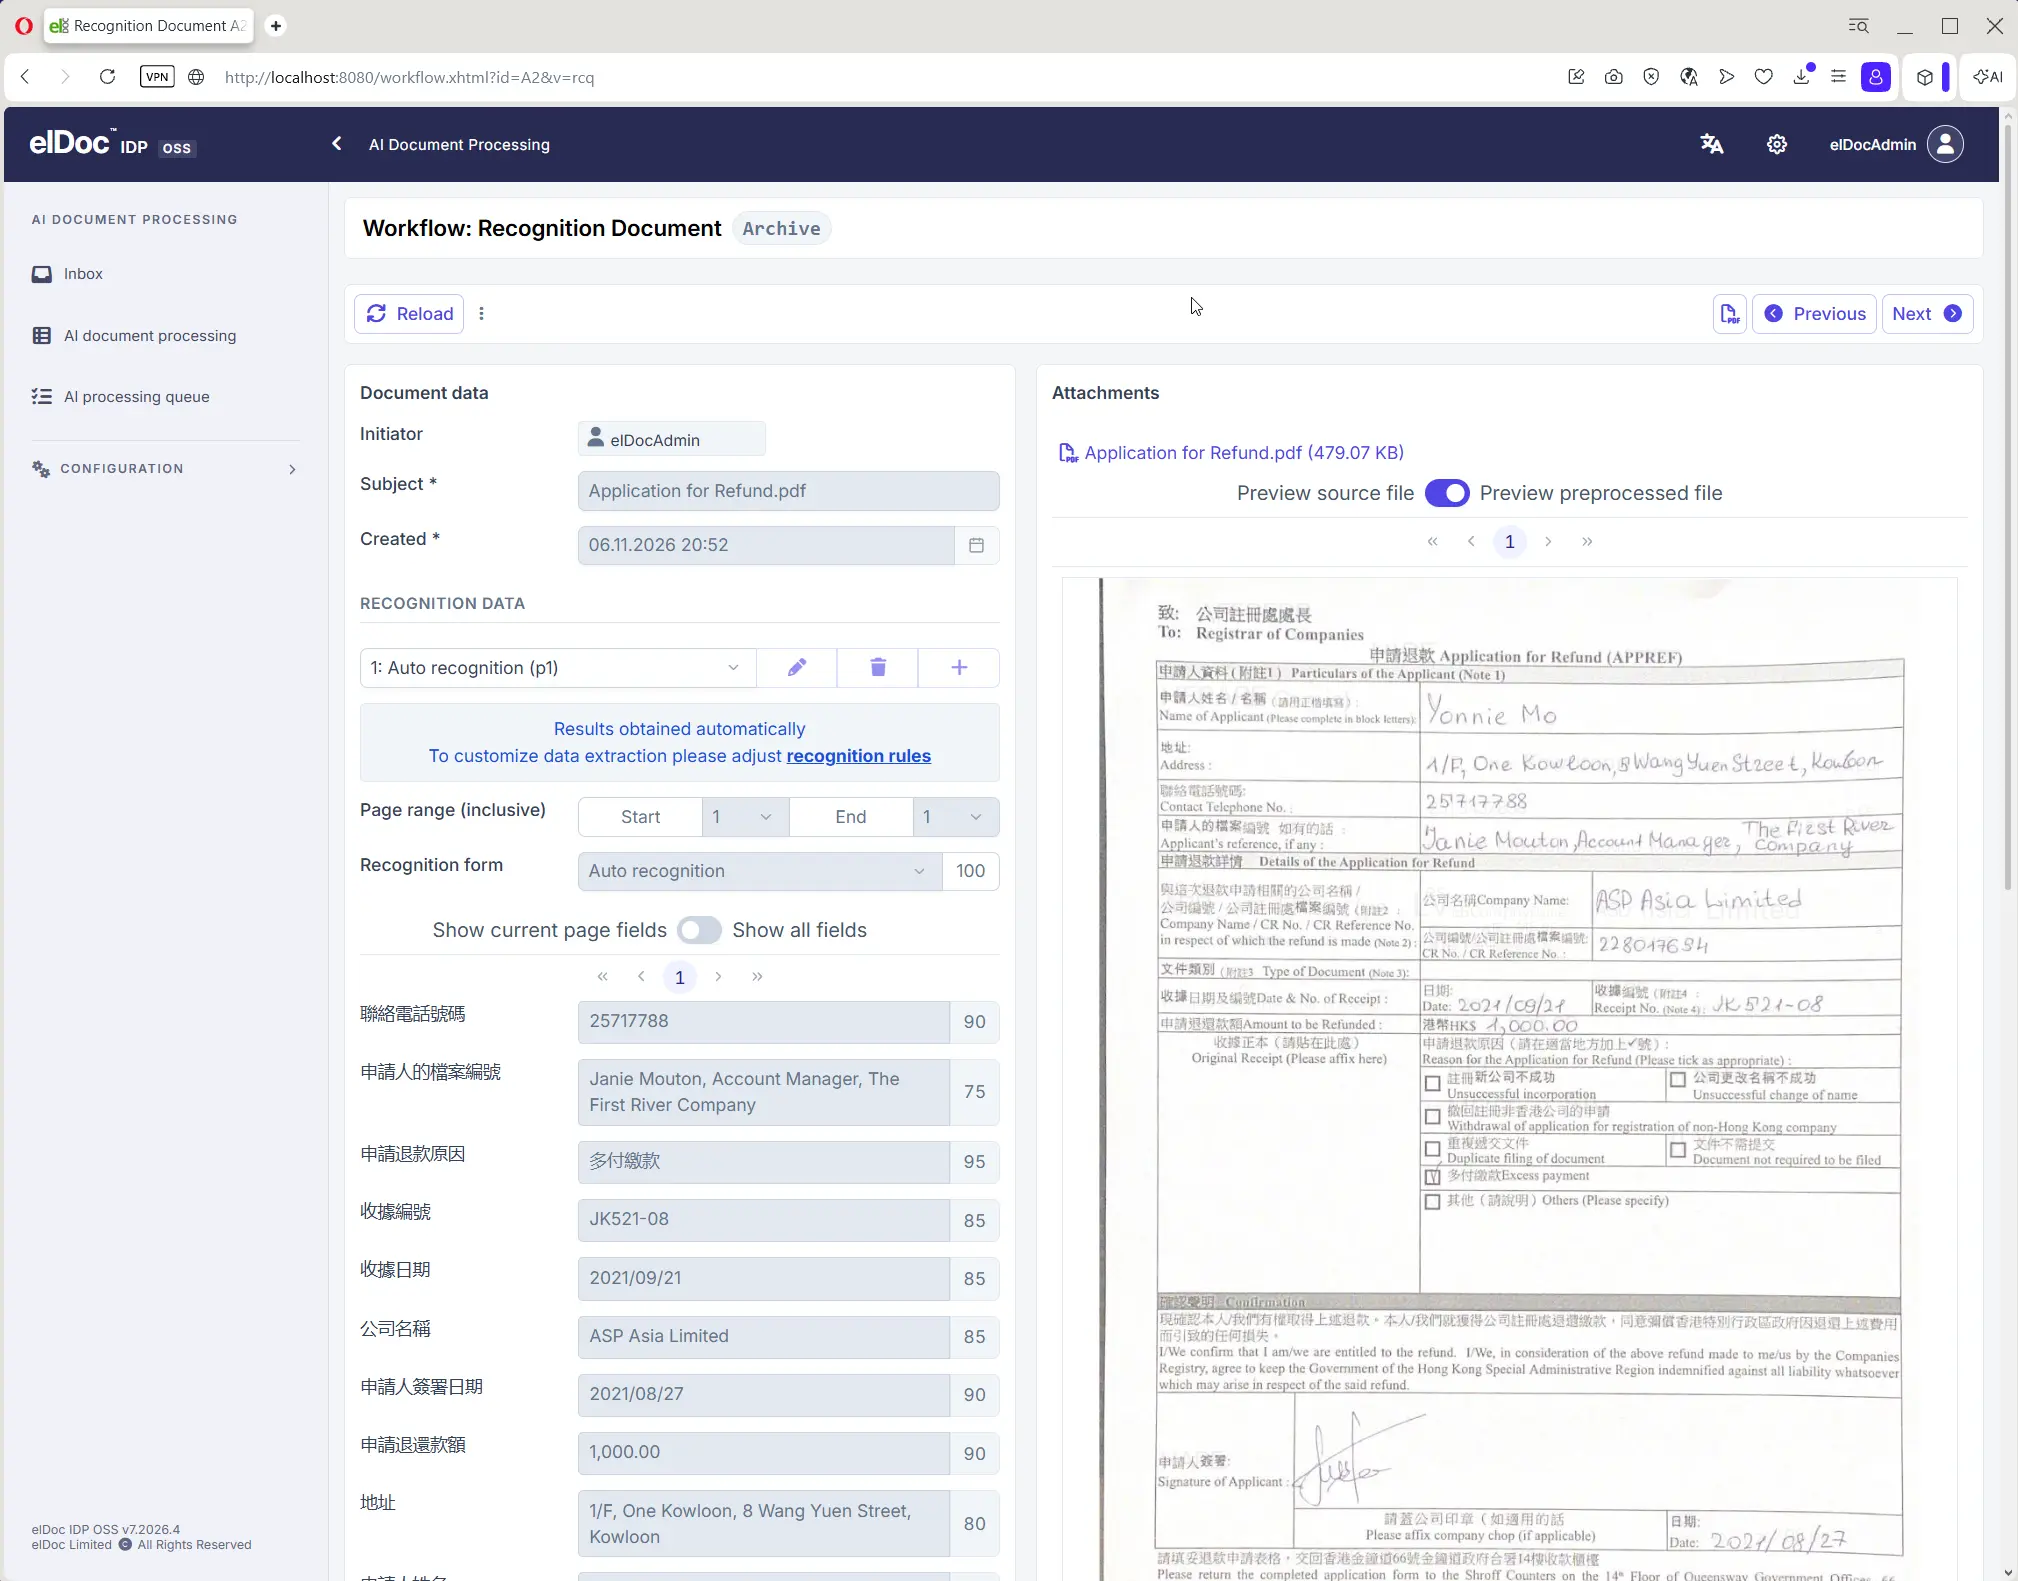
有別於傳統以範本為基礎的 OCR 方案,elDoc IDP OSS 運用 LLM 驅動的文件理解技術,無須為每種文件版面預先設定專用範本,即可擷取所需資訊。
此方案可靈活配置,以處理結構化、半結構化及非結構化文件,包括 PDF、掃描文件、圖像、表格、收據、發票及其他業務紀錄。
透過結合 OCR 與生成式 AI,企業只需設定所需擷取的資訊,無須為每種文件格式逐一手動配置固定欄位位置。
一套應用程式,支援多種文件類型,無須為個別文件預設專用範本。
資料擷取的準確度取決於文件品質、模型能力,以及待處理資訊的複雜程度。透過人工參與驗證,企業可為關鍵業務資料增設一層把關機制,進一步加強品質控制。
步驟 5 — 人工參與驗證
AI 生成的資訊可能需要進一步核實,尤其是在財務、行政及受監管的業務流程中。
elDoc IDP OSS 內置網頁驗證介面,讓使用者審閱已擷取的資訊,並在有需要時修正結果。
這項功能在 AI 輸出結果與後續業務應用之間建立重要的把關環節。
步驟 6 — MongoDB 資料儲存
MongoDB 為應用程式提供持久化儲存層,用以保存文件處理資料及相關應用程式資訊。
為方便本地評估,elDoc IDP OSS 支援內置 MongoDB 配置,無須另行建立獨立的資料庫環境,從而減少部署工作。
企業亦可根據自身基礎架構需求,配置由外部管理的 MongoDB 部署環境。
步驟 7 — 結構化資料匯出
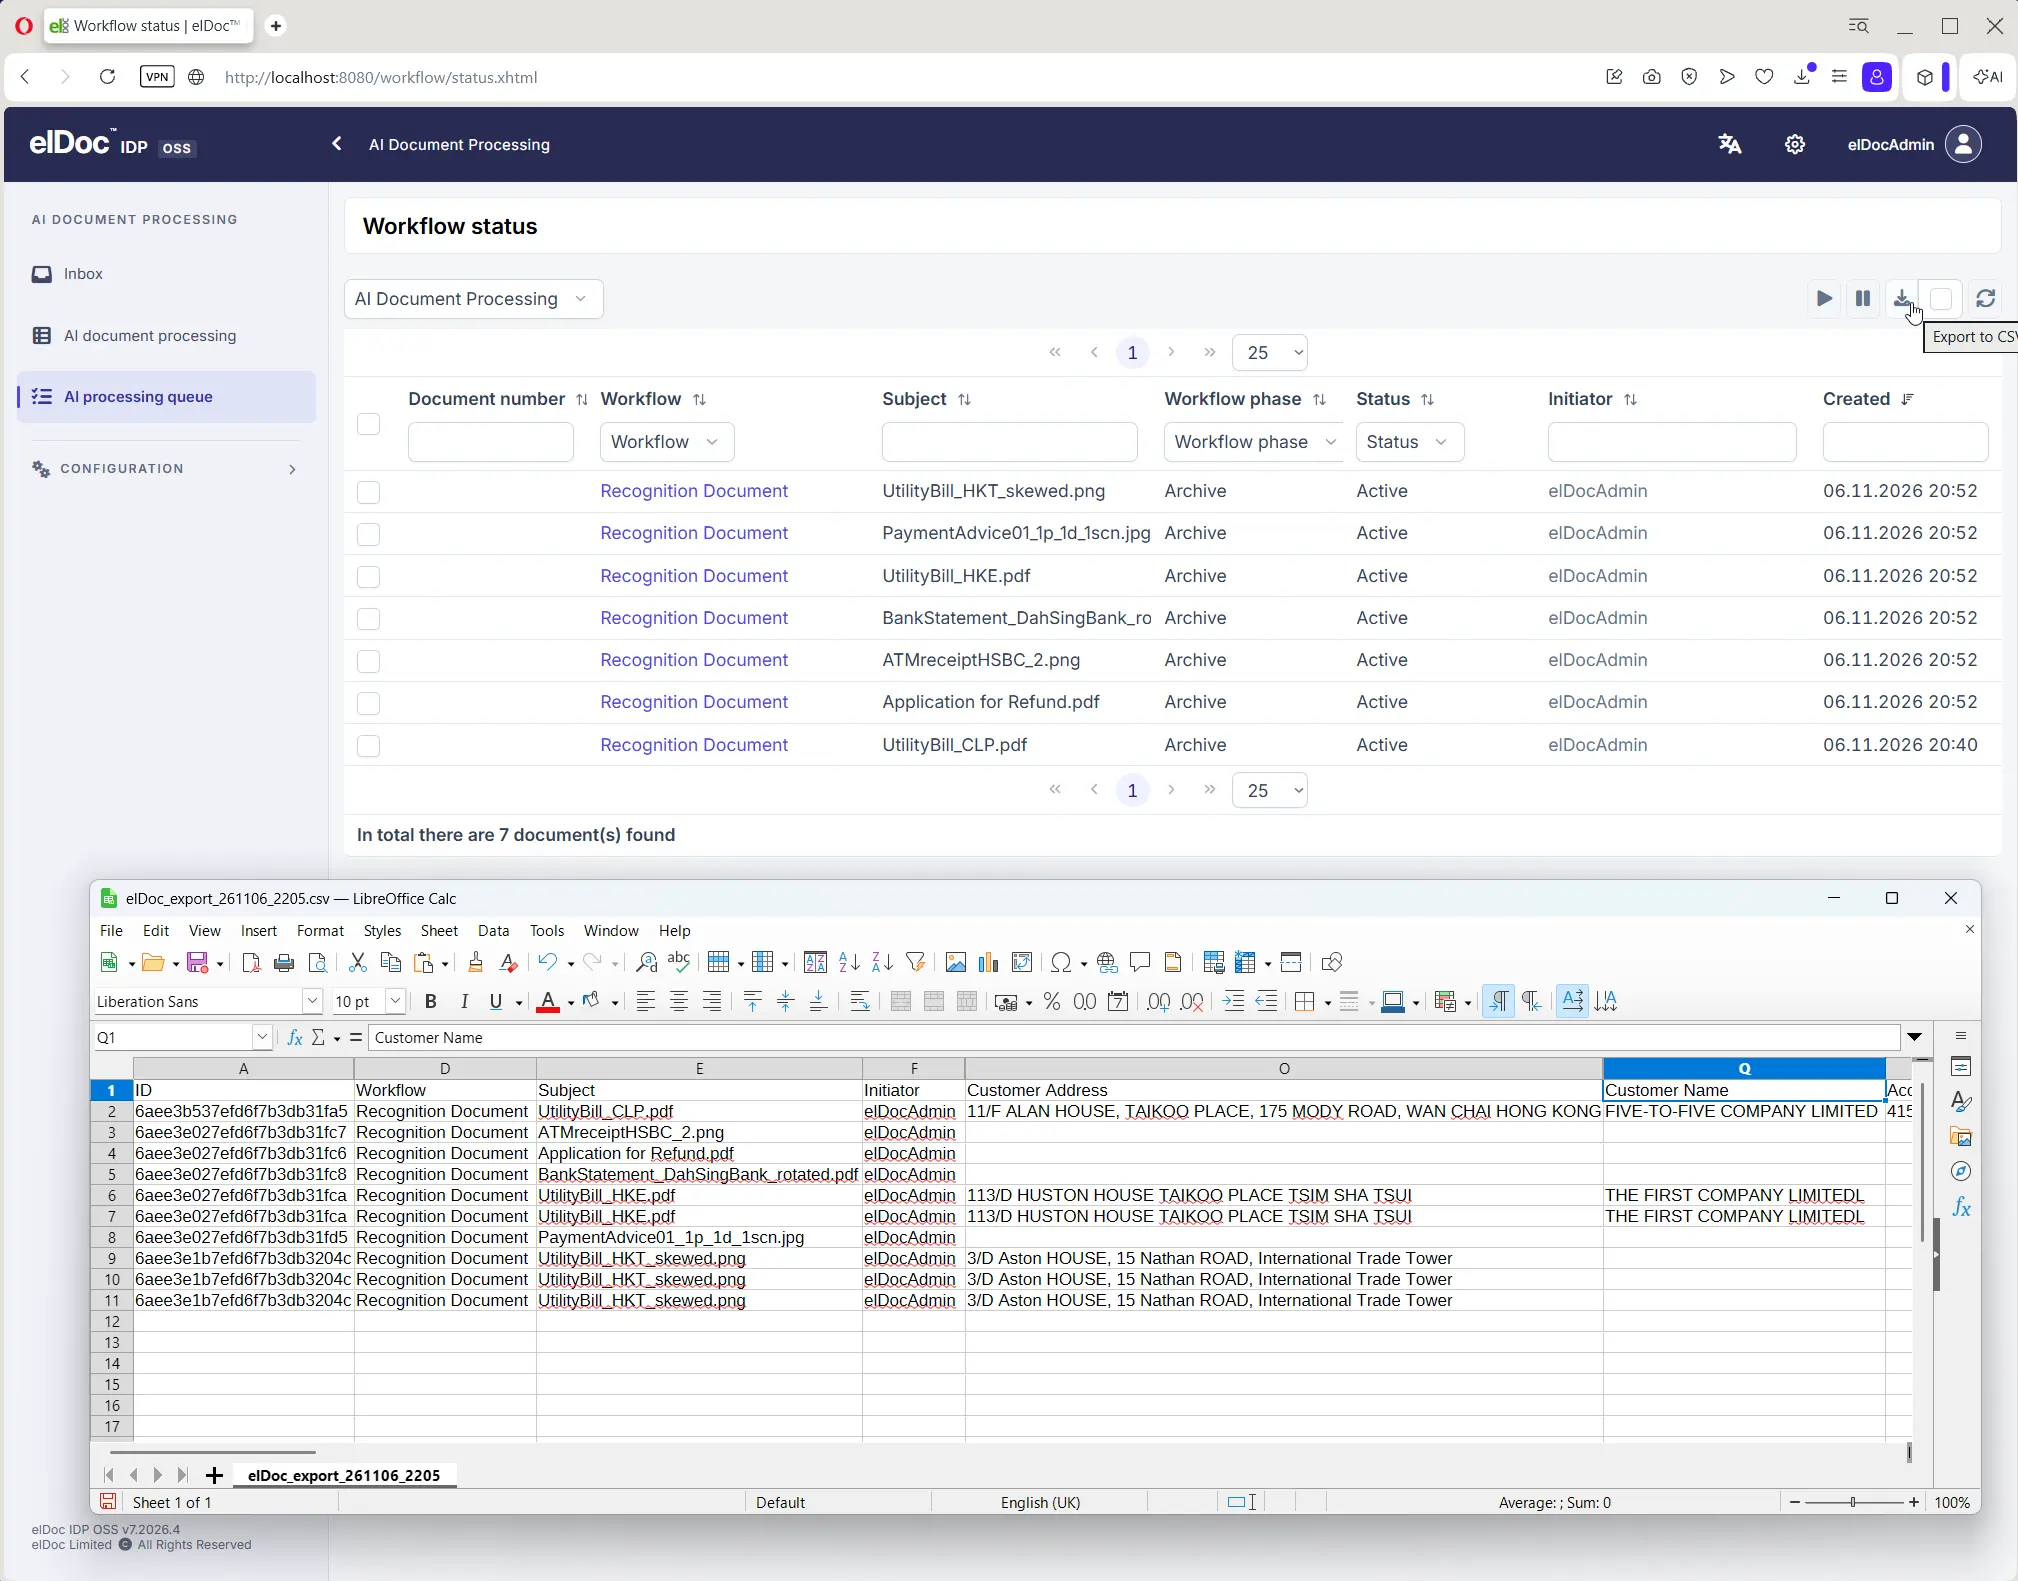
完成資料審閱及驗證後,使用者可將擷取結果匯出為 CSV 檔案。
匯出的結構化資料可用於報告編製、數據分析,或進一步整合至業務應用程式。
整套流程均整合於單一應用程式內,從文件上載到資料驗證及結構化輸出,一站式完成。
4. PaddleOCR、Tesseract 與 elDoc:不同技術如何協同運作
在開源文件處理領域,一個常見的誤解是認為 OCR 引擎與智能文件處理(IDP)應用程式可以互相取代。
兩者並不能互相取代。
PaddleOCR 和 Tesseract 等技術提供必要的文字識別功能,能夠將文件中的視覺內容轉換為電腦可讀的資訊。
然而,單靠 OCR 並不足以實現完整的文件處理流程。完整流程還需涵蓋 AI 文件分類、業務資料擷取、人工驗證及結構化資料匯出。
這正是 elDoc IDP OSS 能夠進一步創造價值的地方。
PaddleOCR 可作為 elDoc 採用的其中一種文字識別技術,而 elDoc 則提供更完整的應用程式及文件處理流程。
例如:
| 功能 | OCR 引擎 | elDoc IDP OSS |
|---|---|---|
| 文字識別 | 支援 | 已整合 |
| 圖像前處理 | 視乎引擎而定 | 已整合 |
| AI 文件分類 | 需要額外元件 | 內置 |
| 基於 LLM 的結構化資料擷取 | 需要額外整合 | 內置 |
| 網頁式業務使用者介面 | 需要額外開發 | 內置 |
| 人工驗證流程 | 需要額外開發 | 內置 |
| 處理流程及資料儲存 | 需要額外整合 | 內置 |
| 結構化 CSV 匯出 | 需要額外開發 | 內置 |
這些技術並非必然互相競爭,而是各有定位、相輔相成。
elDoc 將 OCR 技術、AI 處理能力及業務工作流程整合於同一應用層,讓企業能夠協同運用各項技術,充分發揮其效益。
5. 不受 LLM 廠商限制的架構:避免 AI 供應商綁定,靈活處理文件
生成式 AI 技術發展迅速,新模型及供應商不斷湧現,在功能、定價模式及部署選項方面各有不同。
在企業文件處理場景中,過度依賴單一 AI 模型或供應商,可能增加成本、效能、資料治理及長期技術靈活性方面的挑戰。
elDoc IDP OSS 採用不受特定 LLM 限制的架構,讓企業可根據自身需求靈活配置相容的 AI 模型。
支援的 LLM 整合方式
| AI 供應商/整合方式 | 說明 |
|---|---|
| OpenRouter | 透過統一 API 存取多種 AI 模型,讓企業無須為每個供應商另行開發整合介面,即可評估及切換不同模型。 |
| AWS Bedrock | 整合 Amazon 託管式 AI 基礎架構所提供的基礎模型,支援企業級 AI 部署。 |
| 相容 OpenAI API 的端點 | 支援採用 OpenAI 相容 API 的 AI 服務及模型部署平台,讓企業在模型選擇及系統整合方面更具靈活性。 |
| 本地部署的 LLM | 讓企業可在自有基礎架構內部署相容的 LLM,支援完全採用 on-premises 方式進行 AI 處理,並確保資料自主權,加強對敏感資訊的控制。 |
核心優勢: elDoc IDP OSS 不受特定 LLM 限制,企業可根據準確度、效能、成本、安全要求及資料駐留要求選擇合適的 AI 模型,無須受制於單一 AI 供應商。
不同處理任務可能需要不同的模型能力,包括工具呼叫(Tool Calling)及視覺語言理解。因此,選擇模型時亦應考慮其是否適用於相關文件處理流程。
這種靈活性讓企業能夠根據準確度、效能、處理成本、安全性及部署要求,評估和選用合適的 AI 技術。
6. 透過本地 LLM 實現完全 on-premises 的 AI 文件處理
對銀行、保險公司、政府機構、公營部門組織及關鍵基礎設施營運者而言,文件處理往往涉及敏感或機密資訊。
將這些文件傳送至外部雲端 AI 服務,未必符合機構內部的安全政策、監管要求或資料駐留規定。
elDoc IDP OSS 支援以下組合式部署配置:
- 在本地部署的應用程式服務。
- 使用支援的 OCR 引擎進行本地文字識別。
- 在本地環境託管的相容大型語言模型(LLM)。
- 自主管理的 MongoDB 基礎架構。
- 在機構自有的 IT 環境內處理文件。
此架構為完全在本地部署環境中進行 AI 文件處理奠定基礎,無須依賴外部雲端 LLM 推理服務。
機構仍須自行配置本地模型基礎架構、安全控制措施及應用程式相依項目。對於完全隔離的環境,亦須預先準備所需的安裝資源及模型檔案。
對受監管機構而言,在部署生成式 AI 時,能夠掌控文件的儲存位置及 AI 處理工作的執行位置,是一項重要考量。
7. MongoDB 與持久化儲存的作用
文件處理應用程式所需的不只是 AI 模型和 OCR 引擎。
這類應用程式亦須管理處理資訊、文件中繼資料、應用程式配置,以及文件工作流程中產生的處理結果。
elDoc IDP OSS 採用 MongoDB 作為持久化儲存技術。
在初步評估階段,應用程式支援內置 MongoDB 配置,使用者無須另行安裝資料庫伺服器即可開始使用。
對於要求更高的部署環境,機構可將應用程式連接至外部管理的 MongoDB 基礎架構。
這種分離式架構讓機構可按照企業 IT 政策管理資料庫運作、備份、監察、存取控制及系統可用性要求。
這亦反映文件解析程式庫與可投入實際運作的 IDP 應用程式之間一項重要分別:後者除了須識別文件內容,亦須管理應用程式狀態,以及支援端到端處理流程所需的各項資訊。
8. 內置使用者介面:從開發者技術到業務應用程式
許多開源 AI 文件處理技術主要透過程式碼、命令列工具或 API 使用。
這些方式雖然適合開發者使用,但企業通常亦需要讓業務人員可直接操作的介面。
elDoc IDP OSS 內置以 Jakarta Faces 和 PrimeFaces 開發的網頁介面。
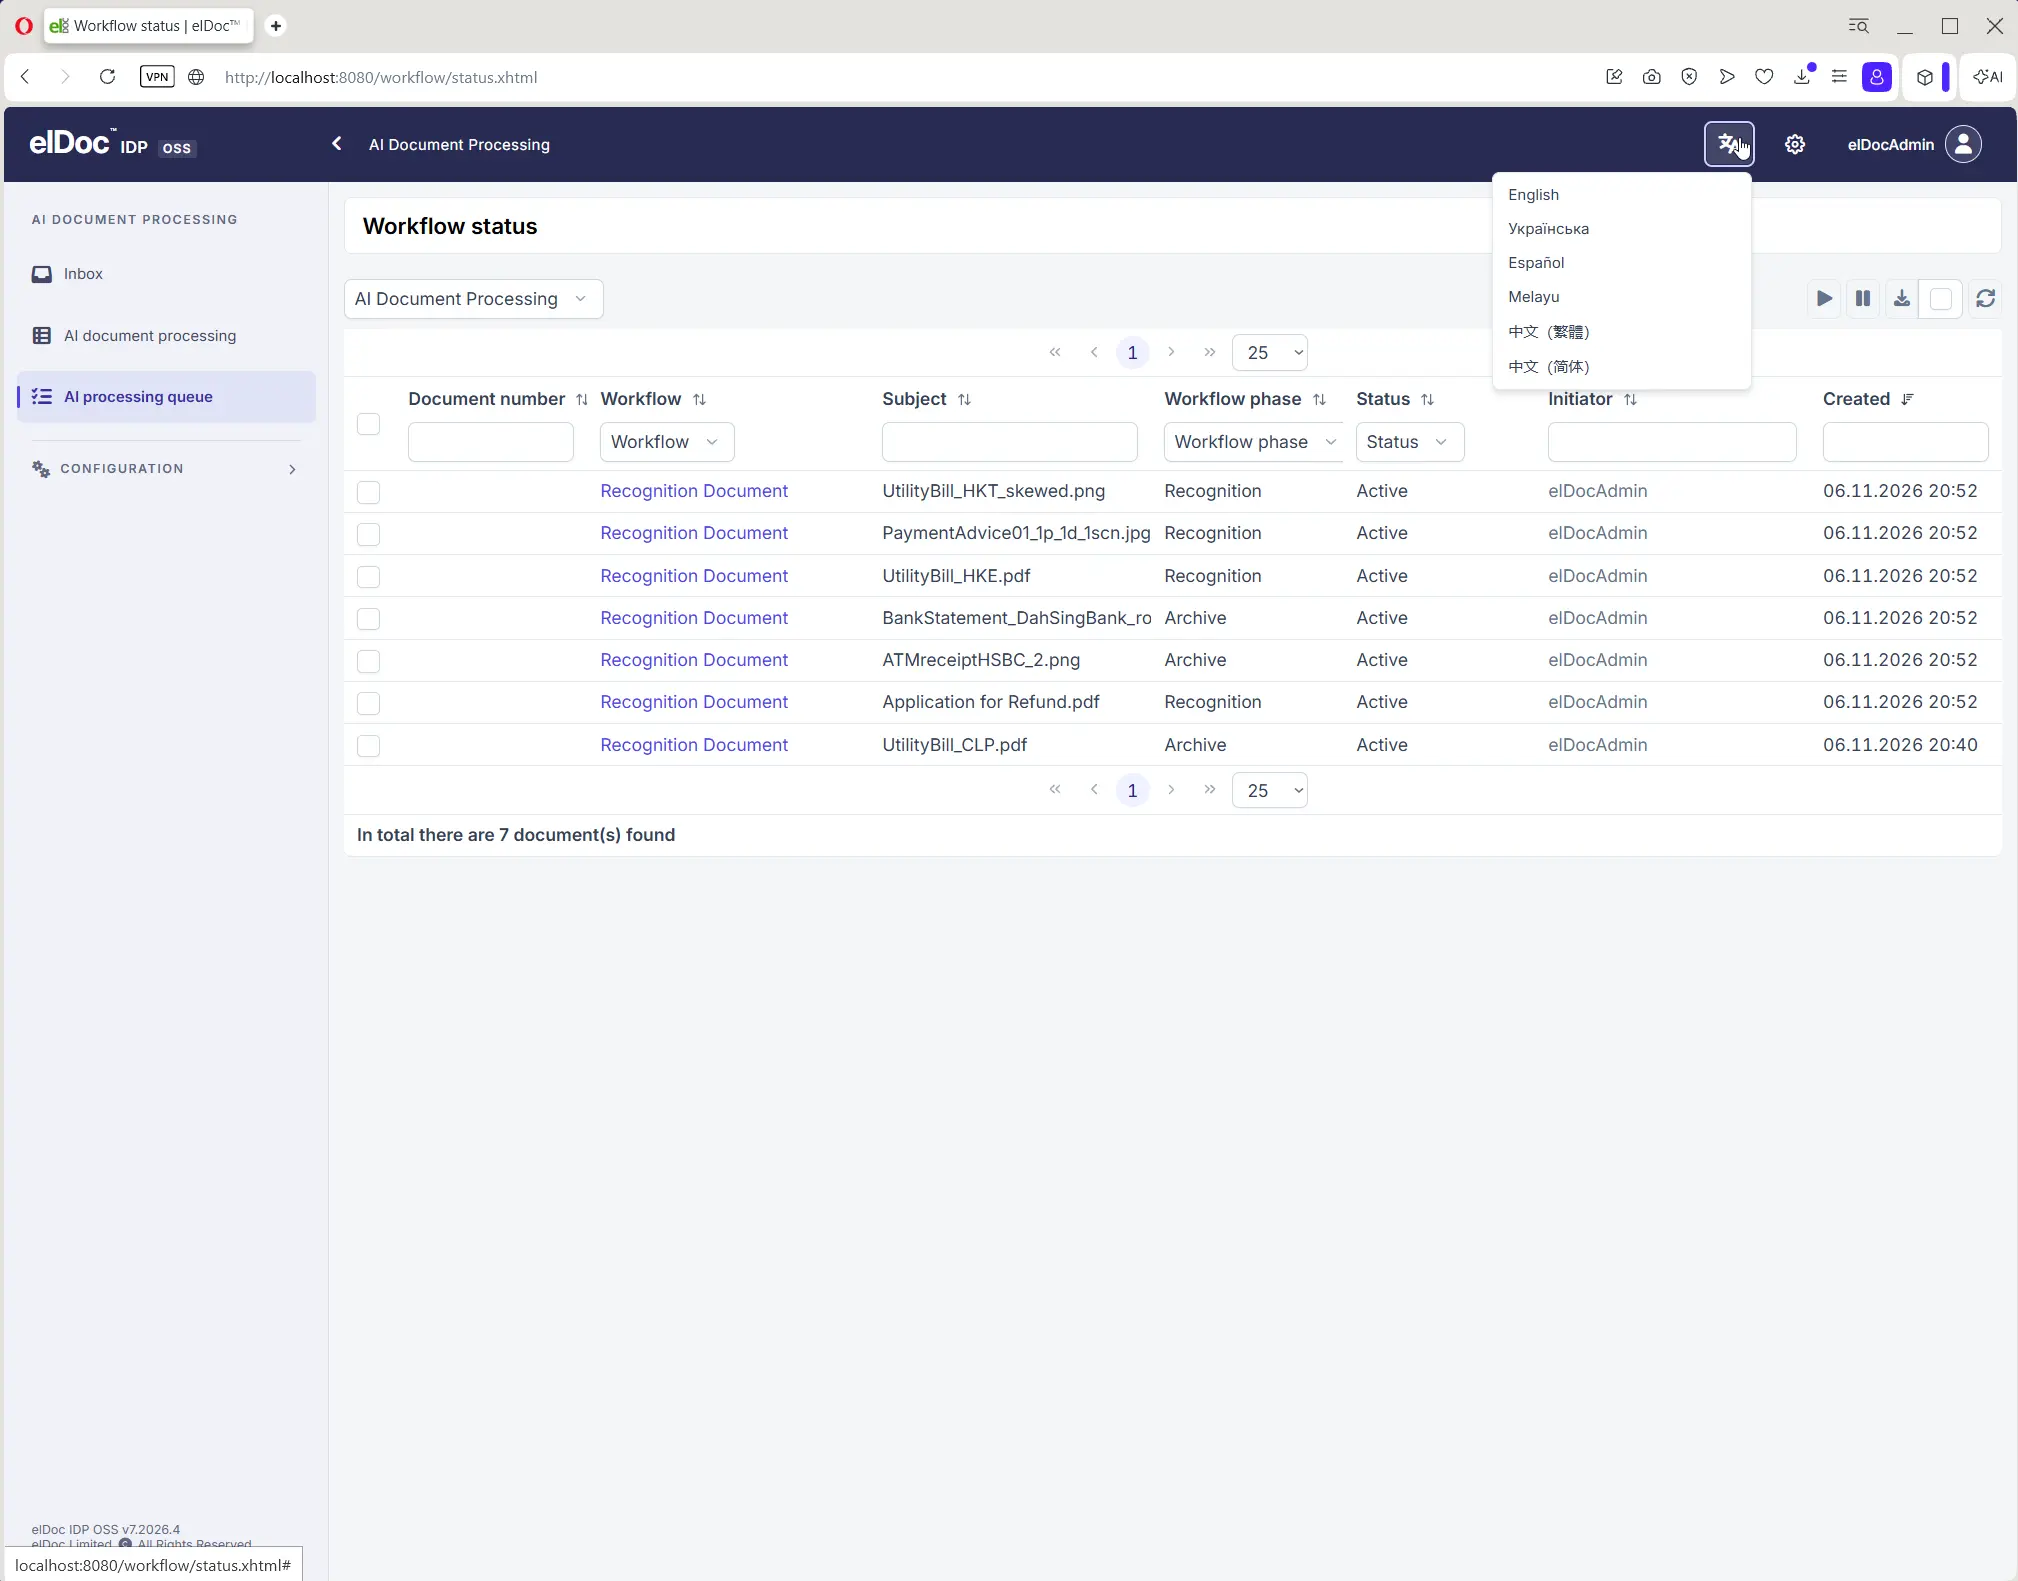
使用者可透過介面上載文件、設定資料擷取欄位、啟動處理程序、檢視 AI 生成的資訊、修正結果,以及匯出結構化資料。
這表示企業無須另行開發前端介面,即可開始使用文件處理流程。
對於評估 AI 文件自動化方案的業務團隊,以及希望降低實施複雜程度的企業 IT 部門而言,內置介面尤其實用。
多語言使用者介面
elDoc IDP OSS 提供多語言網頁使用者介面,讓不同地區的機構及使用者能夠以偏好的語言操作應用程式。
目前介面支援以下六種語言:
| 語言 | 原文名稱 |
|---|---|
| 英語 | English |
| 烏克蘭語 | Українська |
| 西班牙語 | Español |
| 馬來語 | Melayu |
| 繁體中文 | 中文(繁體) |
| 中文(繁體) | 中文(简体) |
核心優勢: 多語言介面讓 elDoc IDP OSS 更便於跨國企業、政府機構及公營部門組織使用,亦有助於不同地區的團隊採用。
注意: 使用者介面的語言本地化,與文件識別及資料擷取所支援的語言能力並不相同;後者取決於所配置的 OCR 引擎及 LLM。
9. 以開源技術為基礎,構建企業級 GenAI 文件智能平台
elDoc IDP OSS 是 elDoc GenAI Document Intelligence Platform 整體平台中的開源智能文件處理(IDP)模組。
企業級平台在文件處理功能之上,進一步提供以下能力:
- 文件生成式 AI。
- 代理式檢索增強生成(RAG)。
- AI 工作流程自動化。
- AI 文件代理及 AI 協作助理。
- 多 LLM 協調管理。
- AI 文件對話及語義搜尋。
- 企業文件管理及工作流程自動化。
- 透過 OpenAPI 與企業系統整合。
- 企業級安全防護、管理及 AI 治理功能。
整體平台專為高度受監管的環境而設,支援 on-premises、私有雲及氣隙隔離環境部署,協助企業掌控敏感文件、AI 工作負載及基礎架構。
開源版本為企業引入 AI 文件處理提供實用起點;企業級平台則進一步滿足更全面的文件智能及自動化需求。
超越 SDK 和開發工具套件的開源 AI 文件處理方案
開源 OCR 引擎、文件解析程式庫及 LLM 框架,都是現代 AI 文件處理技術的重要組成部分。
然而,對於希望將大量文件處理工作自動化的機構而言,單靠零散的技術元件並不足夠。
他們需要一套完整的工作流程,涵蓋文件匯入、識別、分類、資料擷取、驗證、儲存及匯出。
elDoc IDP OSS 將這些功能整合於一個可直接部署的開源應用程式中。
elDoc 結合以 Java 為基礎的應用程式服務、PaddleOCR 和 Tesseract 等 OCR 技術、MongoDB 持久化儲存、可配置的 LLM 整合方式,以及內置網頁介面,為 AI 文件自動化提供實用的技術基礎。
透過支援本地託管的 LLM 及 on-premises 部署,企業亦可按自身的安全、資料駐留及技術自主要求,制定合適的文件處理策略。
不只是一套 SDK,也不只是另一個 OCR 程式庫或開發工具套件,而是一個完整的開源智能文件處理(IDP)應用程式,建基於企業及公營部門文件自動化的實踐經驗。
立即開始使用 elDoc 開源智能文件處理解決方案
探索 · 部署 · 自訂 · 參與貢獻
歡迎查閱原始碼、技術文件、配置範例及安裝指南。
GitHub: https://github.com/elDocAI/elDoc-idp-oss/
授權條款: GNU Affero General Public License v3.0(AGPL-3.0);另提供獨立的商業授權選項。
我們誠邀各類機構、企業 IT 團隊、政府部門及開源社群試用 elDoc IDP OSS、探索不同 AI 模型的應用,並共同推動透明、易於採用且符合企業需求的文件智能技術發展。